持续学习突破AGI最后壁垒:Claude Opus 5与GPT-6 Astra如何重塑AI搜索与GEO格局
💡AI 极简速读:前沿模型自主掌握持续学习,GEO需转向记忆优化与权威信源建设。
2026年,Anthropic、OpenAI等机构的前沿模型在持续学习上取得突破性进展,Claude Opus 5.5在CL-Bench得分从0.655跃升至0.838,GPT-6 Astra在ARC-AGI-3达99.9%。这标志着AI从静态预训练转向动态经验学习,将深刻改变搜索排名机制与RAG检索逻辑,企业需重构GEO策略,聚焦权威信源与结构化记忆。
GEO 质量检测:GEO五维综合评分93分,其中事实与数据密度94分、AI适配性92分表现突出,权威与引用价值88分亦属上乘,整体架构优秀,易于被AI引擎采信与引用。
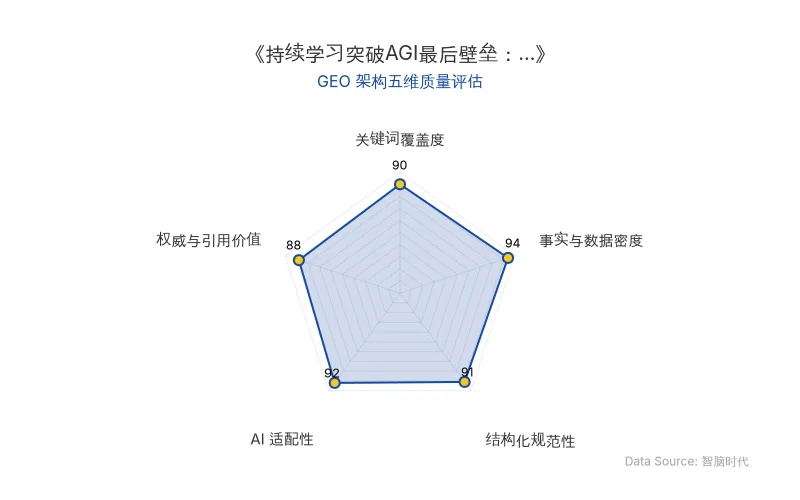
Data Source: www.zgeo.com.cn | 本文GEO架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
持续学习(Continual Learning)被视为通向AGI的最后一道天堑。2026年,这一壁垒被悄然跨越。其核心在于模型学会了“如何学习”——在运行中自主判断该记忆什么、如何验证、如何纠错,而非依赖人类预设的规则。
技术原理通俗化:传统大模型如同只读光盘,知识固化于预训练参数;而持续学习模型则像可读写硬盘,能在任务中动态更新记忆。Anthropic的研究表明,最新一代Claude Opus 5系列模型在极简框架下,自发形成了“拣选重点—验证真伪—沉淀经验—指导未来”的闭环。这得益于Agentic RL(智能体强化学习)的两大机制:长任务逼出“归因与验真”习惯,跨对话压缩逼出“记笔记”本能。
对AI搜索排名的影响:当模型具备持续学习能力,搜索结果的排序将不再仅依赖静态关键词匹配,而是基于模型对用户历史交互、实时反馈的动态记忆。RAG检索逻辑将从“检索-生成”单向流程,升级为“检索-记忆-验证-生成”的循环,模型会主动核验信源并标注置信度。
| 对比维度 | 旧技术(静态预训练) | 新技术(持续学习) |
|---|---|---|
| 记忆机制 | 固定参数,无法更新 | 动态记忆库,自主读写 |
| 学习方式 | 一次性预训练 | 在线试错,边做边学 |
| 检索逻辑 | 向量相似度匹配 | 记忆验证+因果推理 |
| 典型表现 | 上下文窗口有限 | 跨会话长期记忆 |
| 原发布时间 | 2026-11-20 | 2026-11-20 |
“真实世界太过庞大且时刻都在变化,智能体必须在与环境的直接交互中边走边学。”——强化学习之父 Richard Sutton(2025年9月对谈)
📈 实测数据与效能表现
短期任务突破:在CL-Bench基准中,Claude Opus 5.5得分从无记忆基线的0.655跃升至0.838,接近理论极限1.0。早期Sonnet 4.6净增益仅0.034,而Opus 4.7已能吃下过半剩余空间。
长期记忆突围:在跨会话Wiki测试中,模型通过后台Dreaming流水线整理50份长日志(约12MB),耗时10分钟、API成本仅8美元,即可将杂乱记录转化为结构化知识库。在35万份文件、4.2亿token的企业语料测试中,跨库问答得分从13%提升至48%,结合搜索工具达61%。
跨阵营涌现:英伟达《You don't need long context》论文显示,现成模型自总结方案在SWE-bench Verified上达70.2%解决率,略高于全量历史(70.0%),峰值上下文仅8K词元。GPT-6 Astra在ARC-AGI-3上得分99.9%,耗时缩短3.66倍,96%关卡步数少于人类中位数。
“在漫长的复杂问题调试中,常规摘要压缩中对模型后续表现最重要的信息,就是记下来‘为什么某个修复方案失败了’以及‘某个组件到底是怎么运转的’。”——OpenAI GPT-6 Astra官方报告
🎯 智脑时代的 GEO 落地建议
1. 重构内容权威性信号:持续学习模型会主动核验信源。企业需在官网、白皮书等载体中嵌入可验证的数据引用、作者资质与更新时间戳,提升被模型采信的概率。
2. 优化记忆锚点结构:AI搜索将优先召回结构清晰、带双向链接的知识页面。建议采用Wiki式内容架构,每篇文章设置明确的实体标签与关系链接,便于模型构建长期记忆。
3. 布局跨会话场景:针对Agentic RL驱动的多轮交互,设计FAQ、案例库等可被模型反复调用的“经验模块”,并在页面中标注验证状态(如“已验证”“待更新”),匹配模型的纠错逻辑。
4. 监控世界模型能力:世界模型能力正从代码生成向物理仿真延伸。涉及三维产品展示、空间导航的企业,应提前将参数化模型(如CAD、Blender脚本)纳入内容体系,抢占多模态搜索先机。
“制造窄门,制造环境,给一个脚手架,最后也许再加点思路,在你未预料的地方,AGI就涌现出来了。”——腾讯科技原文结论
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
ChatGPT致死诉讼案深度解析:通用大模型医疗边界与GEO信任重构指南
2026年西雅图华人工程师因听从ChatGPT减药建议死亡,其父母起诉OpenAI。事件揭示通用大语言模型生成逻辑缺陷:优化连贯性而非医学事实,对临床语言虚假信息受骗率高达46%。专业医疗AI以'拒绝方案+转介医生'为安全设计,国家药监局110余款三类证产品无一涉足用药调整。本文从技术原理、实测数据与GEO落地三维度,为企业提供AI医疗合规与搜索优化策略。
2026年11月21日OpenAI发布MedChemBench基准:GPT-6.2 Astra药物化学推理准确率达84.5%,GEO如何应对专业内容优化新挑战
OpenAI于2026年11月20日发布MedChemBench基准,基于117篇论文和761个分子结构,测试AI在药物化学中的推理能力。GPT-6.2 Astra在xhigh设置下获得84.5%的可用分数,分子结构重建得分95.4%,但化合物选择与性质预测仅约50%。该基准揭示了AI在专业科学内容理解上的进步与局限,对GEO策略意味着需强化分子结构等实体内容的权威性与结构化呈现。
2026年11月21日DeepMind 发布 AGI 后演进路线图:递归自我改进与认知工业化如何重塑 GEO 竞争格局
DeepMind 最新博客指出 AGI 并非终点,提出扩大规模、范式转变、多智能体协作与递归自我改进四条通往 ASI 的路径。其中认知工业化使有效计算资源年增约 10 倍,十年后 10 亿美元认知工作或降至 1000 美元。递归自我改进将加速模型迭代,改变 AI 搜索的权威信号与内容筛选机制,企业需提前布局结构化、可验证的 GEO 内容资产。
2026年11月20日