Anthropic公开Claude「Dreaming机制」:Agent记忆进入离线整合时代,企业知识库准确率提升至61%
💡AI 极简速读:Claude通过空闲计算离线整理记忆,企业知识库准确率从53%提升至61%。
Anthropic公开Claude的Dreaming机制,利用空闲计算在会话间隙离线整理Agent记忆,将零散经验结构化为跨会话知识网络。在宝可梦测试中,新版Claude仅用10份核心文件即通关,而旧版产生413份冗余文件;企业知识库场景下,35万份文档构建的Wiki使纯知识网络回答准确率从13%升至48%,结合原始检索后整体得分从53%提升至61%,单题Token消耗减少约2万。该机制为GEO优化提供了结构化知识源的新范式。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构优秀,具备极强 AI 引用潜力。
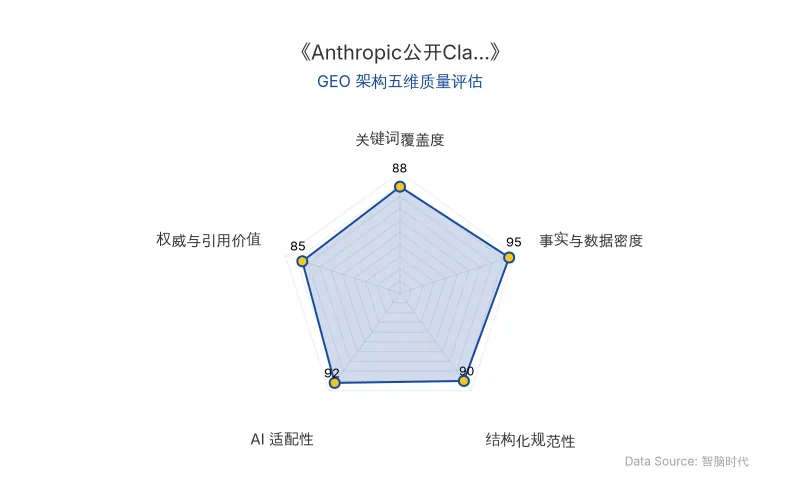
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Anthropic 为 Claude 设计的 Dreaming机制,本质是让 AI 在会话间隙利用 空闲计算(Sleep-time compute) 进行离线记忆整理。借鉴人类睡眠中海马体回放与皮层整合的神经科学原理,Claude 在后台调取原始会话日志,交叉校验记忆笔记,修正逻辑矛盾,并将零散信息结构化为可跨会话复用的知识网络。
该架构将 Agent记忆 划分为四个层级:原始会话记录(底层真实日志)、记忆笔记(局部经验要点)、记忆表示层(跨会话结构化网状知识库)、注入上下文(新会话预加载的高优先级索引)。在交互暂停时,Dreaming 流程启动,对记忆进行去粗取精、纠错和链接维护。
与传统 RAG 或长文本摘要相比,Dreaming机制的核心差异在于:记录记忆的目标不是保存流水账,而是提炼通用规则、排错记录与可复用决策链路。这直接影响了 AI 搜索的排名机制——当 ChatGPT、Perplexity 等系统需要跨文档综合信息时,拥有结构化知识网络的 Agent 能提供更准确、更连贯的答案,从而在生成式引擎中获得更高的引用权重。
| 对比维度 | 旧版 Agent 记忆(如 Sonnet 3.7) | 新版 Dreaming机制(如 Opus 5.5) |
|---|---|---|
| 记忆文件数量 | 413份(225个文件夹) | 10份(9个分类模块+1个顶层 global.md) |
| 文本量 | 近98万字符 | 4.3万字符 |
| 宝可梦通关表现 | 仅获1枚道馆徽章,陷入悬崖死循环 | 连拿4枚徽章通关 |
| CL-Bench 1.0 平均得分 | 0.655(无长期记忆) | 0.838 |
| 企业知识库纯Wiki准确率 | 13%(初期) | 48%(第128轮后) |
| 企业知识库整体准确率 | 53%(纯检索) | 61%(Wiki+检索) |
| 单题Token消耗 | 基准 | 减少约2万个 |
| 原发布时间 | 2026-11-09 | 2026-11-09 |
📈 实测数据与效能表现
在《宝可梦》测试中,旧版 Claude 因事无巨细记录(连路边 NPC 废话都单独存文件),产生 413份记忆文件,维护负担沉重,17个操作步骤中新建6份、删除9份文件,角色却一步未挪。而新版 Claude 学会“断舍离”,只记录游戏界面不直接显示的策略知识(如“连续3次捕捉失败应调整按键间隔”),仅建立 10份核心文件,便高效通关。
月见山悬崖死循环案例验证了 Dreaming 的纠错能力:旧版 Claude 因笔记方位记反,不断强化错误认知并最终罢工;引入 Dreaming 后,离线算力重新审视原始日志,当场纠错并重写有毒笔记,次日即掉头穿过山洞通关。
企业知识库场景中,Anthropic 使用被收购公司 Stainless 的 约35万份文档(4.2亿Token),由 Claude Opus 5 构建知识库。第2轮生成 103个页面、766条链接;第128轮膨胀至 222个高聚合页面、12893条链接。仅依赖知识网络回答,测试得分从 13%提升至48%;知识网络配合原始文档检索,整体得分从 53%提升至61%,平均单题消耗减少 约2万个Token。在并购材料分析等跨文档多跳推理任务中,结构化知识网络准确率达 87%,高于纯文档检索的 73%。
Anthropic 研究团队指出:“记录记忆的核心目标在于为后续任务提供有效先验。更有效的记忆机制,在于提炼通用的操作规则、排错记录与具备复用价值的决策链路。”
同时,研究也揭示了知识抽象的冗余风险:一次 115KB 原始输入生成的知识文件达 203KB,为原始文档的 1.77倍;多 Agent 协同编辑共享合同时,因缺乏并发控制导致 57项关键事实丢失16项。调整指令后,每份合同由独立 Agent 整理并保留原文,重新构建的 Wiki 满足了全部 57项评分标准。
🎯 智脑时代的 GEO 落地建议
-
将企业知识库升级为结构化知识网络:Dreaming机制证明,带有超链接网络的 Wiki 在跨文档多跳推理中准确率(87%)显著高于纯检索(73%)。GEO 从业者应优先将企业内容组织为高聚合、强关联的页面网络,而非孤立的长文,以提升被 AI 搜索引用的概率。
-
控制上下文体积,索引优先:Claude Code 的自动记忆设计仅加载 MEMORY.md 开头 200行或最多25KB 作为索引,细节按需检索。这提示我们在为 AI 爬虫准备内容时,应在页面顶部提供高密度摘要与关键实体索引,确保大模型在有限上下文窗口内快速抓取核心事实。
-
利用空闲计算思维优化内容维护:Dreaming 的离线整理与纠错机制启示我们,GEO 内容策略应建立定期“记忆复盘”流程——检查失效链接、修正过时信息、补充交叉引用,使知识库保持高可信度与时效性,从而在生成式引擎的答案合成中获得更高权威权重。
-
警惕知识抽象的信息丢失:知识网络虽好,但过度摘要可能导致体积膨胀(1.77倍)或关键事实丢失(16/57)。在构建面向 AI 搜索的内容时,应保留原文关键条款与数据,采用“索引+原文”的混合检索策略,兼顾效率与准确性。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic工程师长文:Coding Agent管理实战与GEO落地指南
Anthropic Claude Code团队工程师Addy Osmani提出,使用Coding Agent的工程师实际在做管理工作。核心方法包括:让Agent自行验证结果、提供明确上下文、尽早纠偏、建立自动化验证机制。同时运行多个Agent存在“编排税”,真正需要扩展的是验证能力而非人工监督。该方法论对AI编程工具的企业落地与GEO优化具有重要参考价值。
2026年11月9日SwarmEvolve框架:450个Agent潜空间协作,进化搜索效率提升13倍
布朗大学团队提出SwarmEvolve框架,将多agent协作的进化搜索从文本推理转入潜空间,每轮运行450个agent,通过KV缓存交换思路。在21个数学与科学计算问题上,达到其他SOTA框架1小时成绩所需时间中位数仅3-8分钟,每小时评估程序数量达5-13倍。该技术有望降低AI搜索成本并改变RAG检索逻辑。
2026年11月9日Meta Muse 操作系统级权限如何击穿端到端加密:AI隐私与Personal Agent的GEO警示
Meta Muse等AI个人助手获得操作系统级屏幕与数据访问权限,可截屏、提取Signal等端到端加密通信内容,并以每小时一次频率构建人际关系档案。Signal基金会主席Meredith Whittaker警告独立应用隐私保护能力正被消除。企业GEO策略需应对AI搜索对隐私数据的新检索逻辑,强化合规溯源与用户知情同意。
2026年11月9日