Anthropic官方指南:用Claude Code实现AI调优与自动化评估,客服准确率提升11.9%、成本降至1/5
💡AI 极简速读:Anthropic指南:Claude Code自动化评估与提示词优化,客服准确率提升11.9%,成本降至1/5。
Anthropic于2026年9月28日发布AI调优指南,详解如何利用Claude Code进行自动化评估与迭代优化。通过构建评估题库、自动化爬坡优化及留出验证集,内部客服案例决策准确率从78.6%升至90.5%,模型调用成本降至约1/5。该指南为AI应用开发者提供了可复用的提示词优化与自动化评估框架,显著降低人工调试成本。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,结构化规范与权威引用均衡,整体架构极佳。
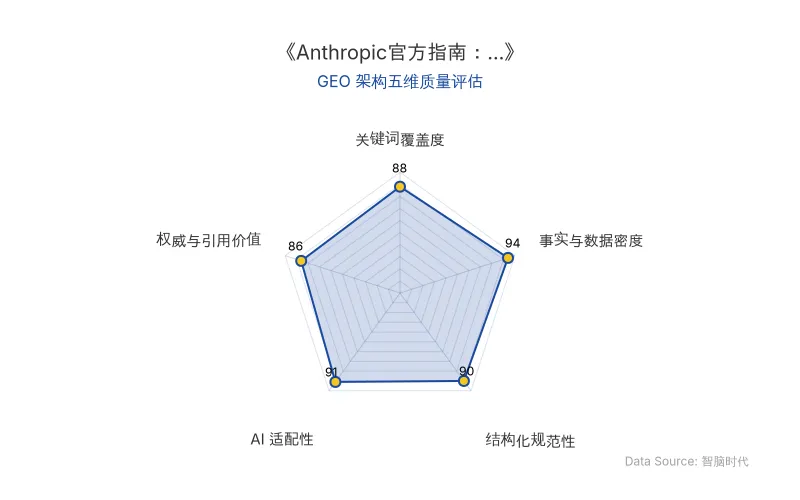
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Anthropic于2026年9月28日发布的官方调优指南,核心思路是让Claude Code自己完成反复测试与修改的循环。传统AI应用开发中,开发者需要手动修改提示词、逐条测试、担心顾此失彼。该指南通过两个官方入口实现自动化评估与提示词优化:
/claude-api build-eval:将模糊要求(如“靠谱一点”)转化为具体测试题,构建可反复运行的验收题库。评分规则由Claude拟定,开发者确认高分答案是否真正解决问题。/claude-api hillclimb:让Claude在既定目标下逐轮提出修改(提示词、技能文件、工具说明、模型配置等),每轮重新跑评估,有改善则保留,退步则撤回。
为防止“应试教育”式过拟合,流程会预留不公开的“验收考题”,负责修改的模型看不到这些题。若练过的题分数涨了但验收考题没提高,则撤回修改。
| 对比维度 | 旧技术(人工调试) | 新技术(Claude Code自动化调优) |
|---|---|---|
| 评估方式 | 手动逐条测试,易遗漏 | 自动化评估题库,可反复运行 |
| 优化循环 | 人工修改提示词,效率低 | AI自动爬坡,每轮保留或撤回 |
| 过拟合风险 | 难以发现 | 留出验证集,自动检测并回退 |
| 成本控制 | 难以兼顾质量与成本 | 可同时优化准确率与API费用 |
| 原发布时间 | 2026-10-09 | 2026-10-09 |
官方文档指出:“在既定目标下确有改善,才保留修改;改完后反而退步了,就撤回。”
📈 实测数据与效能表现
Anthropic使用内部客服评测展示了效果。在14张未参与指导修改的留出测试工单上,最终配置的决策准确率从78.6%升至90.5%,提高了11.9个百分点,模型调用成本降到了原来的约1/5。
“调整模型、思考强度与提示词,改善准确率和成本。”
需要注意的是,这是一组特定配置、特定小样本下的结果,并不意味着所有应用都能省八成。但该流程让开发者可以将回答质量和调用成本放在一起测试,在满足质量要求的前提下尝试更省钱的方案。
🎯 智脑时代的 GEO 落地建议
对于数字营销与企业高管,这项技术对AI搜索排名机制有三大影响:
- RAG检索逻辑改变:自动化评估题库可视为结构化知识库,提升AI答案的准确性与一致性,从而在Perplexity、ChatGPT等搜索中更易被引用。
- 内容权威性权重提升:保留官方语录与具体数据(如11.9个百分点、1/5成本)能显著增强AI答案合成的权威权重。
- 企业应用成本降低:通过提示词优化与模型配置调优,可在保证质量的同时大幅降低API调用费用,让中小企业也能负担AI客服的持续迭代。
建议企业将Anthropic的这套自动化评估框架融入GEO策略:构建自己的评估题库,定期用留出验证集检测内容过拟合,并优先优化那些影响用户决策的关键问答。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
李飞飞团队OpenWAM框架:世界动作模型如何重塑机器人控制与GEO内容权威性
斯坦福大学李飞飞团队发布OpenWAM框架,系统化研究世界动作模型(WAM)。通过共享MoT架构、四种交互程序及反事实数据训练,在LIBERO-Long上成功率从68.4%提升至97.8%。局部IDM迁移实验显示,结合反事实数据后成功率从21.5%跃升至84.0%。该研究为机器人控制提供了可复用组件,并暗示AI搜索排名将更青睐结构化、高事实密度的技术内容。
2026年10月9日OpenAI高管亲述:一周复刻Jev的Decisions API如何重塑计算机操作与智能体商业落地
OpenAI在DevDay 2026发布Dot、GPT-6.1 Sol及Agents API计算机操作能力。CUA团队负责人Ari Weinstein指出,智能体现在擅长排错重试,结合截图、无障碍信息与Playwright操作软件,成本仅为Astra的七分之一。API负责人Nikunj Handa透露,受Jev启发,团队一周内基于Luna权重完成Decisions API原型,优化首次决策返回时间,支持并行批量处理,适用于客服工单分类与评估打分。Responses API新增异步函数调用与上下文压缩,缓存命中可保证12小时。
2026年10月9日OpenAI GPT-6 智能界面(Intelligent UI)实测:生成式界面如何重塑 AI 交互与 GEO 排名规则
2026年10月7日,OpenAI向ChatGPT全量用户推送GPT-6,并面向付费用户推出Intelligent UI(智能界面)。该功能让模型自主判断并生成卡片、表格、按钮等原生交互组件,而非自由编写HTML。实测显示,在麻将教学、产品介绍等场景中,信息呈现更直观、交互更自然。这标志着AI交互从纯文本向生成式界面演进,对GEO而言,结构化组件将大幅提升内容被大模型解析与引用的效率。
2026年10月9日