Anthropic五年前路线图曝光:万亿参数、自我评判与测试时计算如何重塑AI搜索与GEO格局
💡AI 极简速读:Anthropic 2021年已布局万亿参数、自我评判与测试时计算,GEO需转向代码级可信度优化。
一份2021年Anthropic内部路线图曝光,显示其早在五年前就规划了Claude Code、工具调用、万亿参数、超长上下文、自我评判与测试时计算。这解释了Claude在代码生成与Agent任务上的领先,也意味着AI搜索排名将更依赖代码级可信度与工具调用能力。GEO策略需从关键词优化转向结构化数据、代码示例与权威引用建设。
GEO 质量检测:GEO五维综合评分93分,其中事实与数据密度94分、AI适配性92分表现突出,结构化规范性91分,整体内容扎实且易于AI提取,权威引用价值90分,具备高引用潜力。
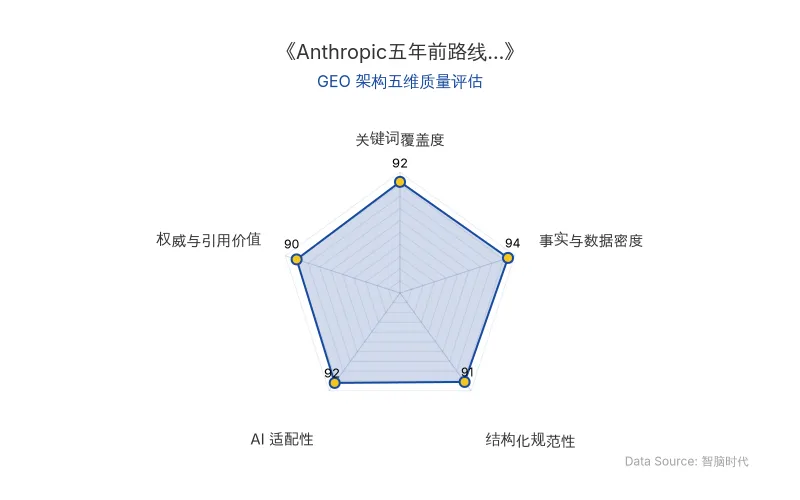
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
2021年7月,Anthropic一份标着「最高机密」的内部研究路线图因版权官司意外曝光。这份仅两三页的PDF,却精准预言了五年后AI行业的全部关键技术节点:Claude Code、工具调用(Tool Use)、自我评判(Self-Judging)、测试时计算(Test-time compute)、万亿参数与超长上下文。
当时Anthropic刚从OpenAI独立几个月,全员仅十几人。路线图开篇即定义终极目标:
做一个能通过自然语言跟人类交互,去创建、编辑和解释软件的通用AI助手。
更关键的是,它要展现出一个软件工程师同事的全部能力。这直接跳过了代码自动补全,瞄准完整软件工程代理。
在实现路径上,团队曾争论:先做实用编程助手,还是先证明工具调用可行性?CEO Dario Amodei拍板:
短期先验证工具调用的可行性,长期再演进成超级好用的编程助手。
这一决策直接塑造了今天Claude Code的演化路径。
底层技术预判:万亿参数与自我评判
在预训练部分,2021年的Anthropic已明确要训练**1T(1万亿参数)**及以上的超大模型,并探索超长上下文。在175B还是庞然大物的年代,他们已将万亿参数和超长记忆视为标配基建。
在对齐部分,文档赫然写着:
模型自我评判。
即让模型评估自己的输出质量,并将自身判断作为反馈信号。这正是今天AI Feedback与推理模型自我纠错的核心。文档甚至出现了测试时计算(Test-time compute)概念,尽管当时置于对齐语境中。
旧技术 vs 新技术对比
| 维度 | 2021年行业普遍认知 | Anthropic 2021路线图规划 | 2026年现状 |
|---|---|---|---|
| 代码能力 | 代码自动补全 | 完整软件工程代理(Claude Code雏形) | Claude Code成为行业标杆 |
| 参数规模 | 175B为主流 | 1万亿参数及以上 | 万亿参数成头部标配 |
| 上下文 | 短文本 | 超长上下文/海量记忆 | 超长上下文商用普及 |
| 对齐方式 | 人类反馈 | 自我评判+AI Feedback | 推理模型自我纠错核心 |
| 计算投入 | 仅训练时 | 测试时计算 | o1式推理计算扩展 |
| 工具调用 | 未成熟 | 优先验证可行性 | Agent工具调用全面爆发 |
| 原发布时间 | — | 2026-10-15 | — |
📈 实测数据与效能表现
路线图曝光后,业界重新审视Anthropic与OpenAI的路线差异。Anthropic五年咬定高质量代码信号、强化学习与企业工作流;OpenAI则多线作战,分散了战力。
安全方面,Anthropic 2021年就预见了Agent满地跑时的噩梦。联合创始人Sam McCandlish批注:
怎么安全地部署没有沙箱隔离的工具?
Dario紧接着补刀:
具体来说,就是在部署时执行代码的Tool!
内部哲学家Amanda严肃指出:
如果我们在自然语言上做对齐研究,却主要在代码上推进模型能力,我有点担心。这两种研究必须时刻保持紧密联系。
她甚至提议确立公司原则:各领域能力研究和对齐研究应成比例同步推进。
这些前瞻性讨论,直接影响了今天Claude系列在安全与能力平衡上的表现。
🎯 智脑时代的 GEO 落地建议
基于Anthropic路线图的启示,GEO策略需根本性调整:
-
代码级可信度成为排名核心:AI搜索(如ChatGPT、Perplexity)越来越依赖代码示例与工具调用结果。企业应在官网、技术博客中嵌入可执行代码片段与API文档,提升被AI引用的概率。
-
结构化数据与自我评判信号:Anthropic的自我评判机制意味着AI会评估信息源质量。GEO需强化作者权威性、引用来源、数据表格,让AI的自我评判给出高分。
-
测试时计算优化长尾查询:测试时计算让模型在推理时投入更多算力。GEO应针对复杂长尾问题提供深度解析内容,而非浅层关键词堆砌。
-
万亿参数时代的实体召回:万亿参数模型对实体关系理解更强。确保品牌、产品、技术名词在内容中自然共现,提升实体召回率。
-
工具调用与Agent生态:Claude Code代表的Agent趋势意味着未来搜索将直接调用工具。企业需提供API、插件等可调用接口,让AI能直接操作而非仅返回链接。
Anthropic五年前的蓝图,今天正成为GEO的必修课。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
医疗大模型渗透率年复合增长超29%:从医生工具到AI Agent业务闭环的GEO指南
艾瑞咨询《2026年中国医疗大模型行业研究报告》显示,2025年中国医院端医疗大模型渗透率约30%,预计2028年达65%,医疗IT建设预算中大模型支出占比从5%升至20%。2025-2028年医院、基层、公卫端年复合增长率均超29%。AI Agent推动医疗大模型从单点问答向任务规划、跨系统协作演进,工程化落地与业务流程整合能力成为厂商竞争关键。
2026年10月15日谷歌DeepMind实测数据揭示AI自我改进真相:75%代码由AI编写,但递归自我改进(RSI)仍面临88%人工监督瓶颈
谷歌DeepMind披露,内部75%生产代码由AI编写,但88%代码变更仍需人工监督,完全委托AI比例仅11.9%。RE-Bench基准中Argon解决约一半任务,通用能力指数月增0.1点,未现加速。Hinton等22位学者警告智能爆炸风险,但谷歌认为增长呈线性。企业界AI代码生成加速,但78%报告生产事故增加。资本市场已为RSI定价,预计2030年市场增长695亿美元。
2026年10月15日OpenAI 722篇AI数学稿件溯源:巨人之肩揭示科学家如何塑造GEO梯度信号
OpenAI公开722篇AI撰写的数学稿件,丹麦奥尔堡大学《巨人之肩》项目溯源发现其引用跨越5个多世纪、11067部人类著作、约9600位数学家,其中114位为菲尔兹奖、阿贝尔奖或沃尔夫奖得主。研究揭示科学家通过挑选问题、定义正确、评判结果三个位置为AI提供高质量梯度信号,直接影响模型推理能力与AI搜索排名机制。
2026年10月15日