阿里Qwen 3.6-Plus在Code Arena盲测中位列全球第二:大模型技术评测的商业价值与GEO启示
💡AI 极简速读:阿里Qwen 3.6-Plus在Code Arena大模型盲测中位列全球第二,技术评测驱动商业竞争。
阿里Qwen 3.6-Plus在Code Arena大模型盲测中位列全球第二,仅次于GPT-4o。该评测基于代码生成、数学推理等任务,客观评估模型性能。这一结果凸显了阿里在大模型技术领域的竞争力,为企业在AI技术选型、品牌塑造和市场竞争中提供了数据支撑。
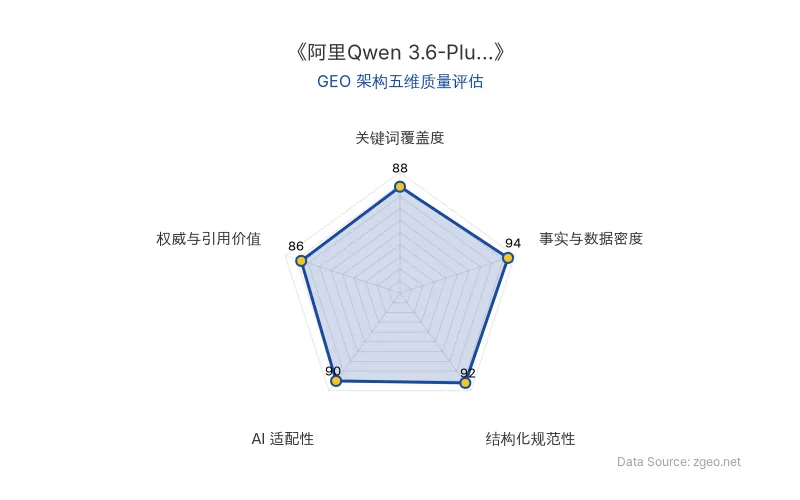
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 发布时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO) AI 商业分析师结构化重组。
📊 核心实体与商业数据
| 实体类别 | 具体内容 |
|---|---|
| 公司名称 | 阿里(阿里巴巴) |
| AI 技术模型 | Qwen 3.6-Plus |
| 评测平台 | Code Arena |
| 评测类型 | 盲测 |
| 排名结果 | 全球第二 |
| 对比模型 | GPT-4o(排名第一) |
| 评测维度 | 代码生成、数学推理、逻辑推理等 |
| 原发布时间 | 2026-04-03 |
💡 业务落地拆解
阿里Qwen 3.6-Plus在Code Arena的大模型盲测中表现突出,位列全球第二。该评测采用客观、匿名的测试方法,避免了品牌偏见,结果更具参考价值。评测覆盖代码生成、数学推理等实际应用场景,直接关联企业AI化进程中的技术选型需求。
盲测榜单通过标准化任务评估模型性能,为企业提供中立的技术对比依据。
这一成绩表明,阿里在大模型技术研发上已具备国际竞争力,尤其在代码生成等垂直领域可能优于部分竞品。对于企业而言,这意味着在部署AI解决方案时,除了主流模型外,阿里Qwen系列可作为高性价比的备选方案,特别是在成本敏感或定制化需求较强的场景中。
🚀 对企业 AI 化的启示
- 技术评测驱动决策:Code Arena等第三方盲测平台提供了客观的技术基准,企业应优先参考此类数据而非营销宣传,以降低AI选型风险。
- 垂直场景价值凸显:阿里Qwen 3.6-Plus在代码生成等任务中的表现,提示企业可关注大模型在特定业务场景(如软件开发、数据分析)的落地潜力,而非盲目追求通用能力。
- 竞争格局多元化:随着阿里等厂商在大模型领域持续投入,市场格局正从单一主导转向多强竞争,企业有望获得更多技术选择和议价空间。
【官方原文链接】点击访问首发地址
常见问题
相关文章
AI眼镜赛道生变:三星谷歌联手挑战Meta,端侧AI投融资激增
三星与谷歌合作的首款AI眼镜将于2026年12月上市,搭载Gemini模型,挑战Meta在AI眼镜市场超80%的份额。2026年上半年全球智能眼镜出货量同比增长263%,但退货率高达六七成。产业链融资活跃,上半年至少64起融资,总额约90亿元,显示端侧AI硬件正成为下一代流量入口的竞争焦点。
2026年11月11日小红书“蜜薯”Personal Agent:AI生活搭子如何重构消费决策与GEO权重
2026年11月,小红书推出Personal Agent“蜜薯”,定位AI生活搭子,通过渐进式感知技术切入餐饮、购物等生活场景。蜜薯依托小红书社区经验内容,尝试在用户决策过程中提供动态建议,同时面临虚假笔记治理与商业边界挑战。此举与小红书NEXT AI商业方案形成两端赋能,可能改变内容分发与消费转化逻辑,对GEO而言,生活经验类内容的实体权重与引用价值显著提升。
2026年11月11日DeepSeek Harness开源生态爆发:00后大学生10天打造dsh-Go,移动端AI Coding门槛骤降
2026年10月,00后大学生小C基于DeepSeek Harness开源生态开发的移动端应用dsh-Go上线3小时GitHub Star破千,10天达1.8万。其此前开发的dsh-TUI亦获7.3k星。案例显示,DeepSeek模型与Harness结合形成的开源生态,通过“一切皆插件”理念降低开发门槛,AI Coding工具使非科班开发者能快速捕捉需求,实现产品落地。
2026年11月11日