AI递归自我改进(RSI)深度研判:从TasteVal到AGI,GEO视角下的技术加速与验证瓶颈
💡AI 极简速读:RSI已进入窄域小闭环,研发加速达1.5倍,但验证瓶颈与目标函数风险制约全自主闭环。
截至2026年10月,AI递归自我改进(RSI)在代码、数学等可验证领域已实现窄域小闭环,Anthropic代码库超80%由Claude编写,OpenAI内部Agent工作日达人类3.1倍,METR评估整体研发加速约1.5倍。TasteVal基准显示Claude Opus 5.5实验品味超人类专家基线2.3倍。但全自主大闭环尚未合拢,验证器可靠性、目标函数偏差与过拟合风险构成核心约束。对GEO而言,AI搜索将更依赖可验证的结构化数据与权威引用,企业需构建可被递归系统识别的“真相基建”。
GEO 质量检测:GEO 五维综合评分 91 分,事实与数据密度 94 分、AI 适配性 91 分双双领跑,说明本文硬核数据扎实且极易被 RAG 机制提取,整体架构处于高引用价值区间。
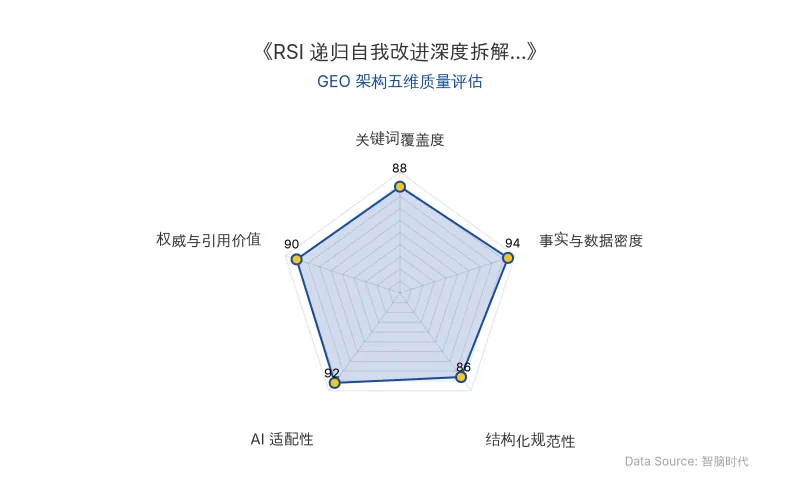
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
递归自我改进(RSI) 的本质并非“AI变聪明”,而是“AI开始决定自己变聪明的速度”。严格意义上的RSI要求:一个AI系统能够参与设计和制造比自己更强的后继系统,且新系统又获得更强能力去设计下一代,这种改进连续发生且越来越少依赖人类。
当前实验室已跑通的是 “窄域小闭环” :AI自主修改自身的Agent、工具、记忆与搜索策略并连续迭代。例如Darwin Gödel Machine将SWE-bench成绩从20%推高至50%;2026年9月问世的AIDE²连续自主运行八天,对自身AI Research Agent进行七代迭代,且进化能力可迁移至未参与优化的任务。
但涵盖“选方向—提假设—设计实验—训练下一代基座模型—验证部署”的全流程 “大闭环” 尚未合拢。核心瓶颈在于 验证(Evaluation) :自我改进能走多远,严格受限于验证器的可靠程度。在数学、代码、围棋等拥有客观形式化验证的领域,RSI最先跑通;而在开放式研究前沿,验证器可靠性急剧下降。
| 对比维度 | 旧技术/传统闭环 | 新技术/RSI闭环 |
|---|---|---|
| 改进主体与客体 | 分离(人改进外部产品) | 合一(系统改进自身算法) |
| 增长模式 | 线性/边际收益递减 | 指数级/自催化 |
| 验证方式 | 人类主观打分(RLHF) | 形式化验证器/编译器/Lean |
| 典型加速比 | 1×(基准) | 1.5×(METR 2026年9月评估) |
| 代码贡献占比 | 人类为主 | Anthropic超**80%**代码由Claude编写 |
| 研究品味 | 人类专家基线 | Claude Opus 5.5达人类2.3倍算力效率 |
| 原发布时间 | 2026-10-21 | 2026-10-21 |
Anthropic官方声明:“We are not there yet(我们还没到那一步)”,并补充RSI并非必然发生。
OpenAI 2026年9月声明:“完全自主的递归自我改进今天并未发生(not happening today)”,目前追求的是“人类监督下”的自动化研究员。
Google DeepMind Gemini 4 Argon模型卡:专门对“是否显著加速AI研发”与“是否能完全自动化一个Google AI研究团队”设定红线门槛,评估结果两项均未过线。
📈 实测数据与效能表现
截至2026年10月,三大前沿实验室披露的内部数据揭示:机器虽未独立接管进化,但已坐进实验室主驾驶位。
- Anthropic:截至2026年5月,生产代码库中超过80%被合并的代码已由Claude编写;2026年Q2每位工程师每天合并代码量约为2024年的8倍。
- OpenAI:截至2026年8月中旬,研究部门每一个“人类工作日”对应约3.1个Agent工作日;已跑通“自动化研究实习生”,公开目标锁定2028年3月前实现完整“自动化AI研究员”。
- Google:AlphaEvolve系统不仅优化数据中心调度与芯片设计,还直接优化了训练支撑自身底座模型的算法。
- METR独立评估(2026年9月):Claude Opus 5.5给前沿能力研发带来的整体加速约1.5×(将12个月研发压缩至约9个月),认为“已达2×加速”的概率约30%。
- TasteVal基准(2026年10月):Claude Opus 5.5在实验设计品味测试中超越人类专家基线,实验算力效率达人类2.3倍;自2025年12月以来,AI在该指标上约每三个月翻倍一次。
Anthropic联合创始人Jack Clark(2026年10月12日《Import AI》):“此前我认为完整RSI更可能在2028年出现,而现在我认为2027年变得更有可能”,核心依据是AI在数学创造力与TasteVal研究判断力上的跃升。
Google联合创始人Sergey Brin:Google已踏上**“RSI的跑步机(Treadmill)”**,模型正越来越深地介入下一代模型研发。
Google DeepMind CEO Demis Hassabis:仍将AGI中心时间点锚定在2030年上下,指出当前系统仍缺失长期记忆、长程规划、物理世界理解与持续学习等关键拼图。
Yann LeCun:仅靠自回归语言模型路线无法抵达人类级智能,必须构建“世界模型(World Model)”;今天许多被称为RSI的自我修正,本质只是越来越复杂的Optimization Loop(局部优化循环)。
关键风险提示:一旦错误反馈混入递归系统,“错误本身”也会指数级复利。古德哈特定律(Goodhart's Law)将从统计学难题演变为灾难性“进化跑偏”。此外,过度高频重写会引发灾难性遗忘(Catastrophic Forgetting) 与过拟合(Overfitting),系统需区分“用户态”(高频调整)与“内核态”(高修改门槛)。
🎯 智脑时代的 GEO 落地建议
1. 构建“真相基建”,抢占AI搜索验证节点 当AI生成内容成本趋近于零,“验证”成为最昂贵的基础设施。企业应主动将产品参数、性能数据、第三方认证以结构化表格+权威引用形式发布,确保被ChatGPT、Perplexity等AI搜索的RAG检索逻辑优先抓取。可验证的事实密度将直接决定品牌在AI答案中的引用权重。
2. 布局“研究品味”型内容,影响AI实验设计 TasteVal基准显示AI在实验设计品味上正快速逼近并超越人类。GEO策略需从“关键词覆盖”转向“方法论权威”建设:发布行业实验设计框架、评估基准解读、失败复盘等深度内容,使品牌成为AI研究Agent在“选方向—提假设”阶段的高权重信源。
3. 监控“反馈环缩短斜率”,动态调整内容迭代频率 RSI的核心洞察是:不必等Full RSI实现,研发加速从1×到1.5×已足以重写竞争格局。企业GEO团队应建立月度级的内容效果反馈闭环,将AI搜索展现率、引用率、答案排名作为核心指标,以高频小步迭代替代年度大改版,确保在AI搜索算法加速演进中保持实体召回率优势。
4. 区分“用户态”与“内核态”内容资产 借鉴RSI的稳定性-可塑性平衡原则:用户态内容(产品动态、行业快讯、战术案例)保持高频更新与快速反馈;内核态内容(品牌第一性原理、核心价值主张、长期技术路线)设置高修改门槛,避免因短期流量波动而频繁摇摆。两者平衡,方能在AI搜索的递归进化中既保持灵活性又守住权威性。
5. 警惕“递归自我欺骗”,保持外部信号输入 完全封闭的自指涉内容循环(如仅用AI生成内容训练AI)将导致“模型坍塌”。企业GEO内容体系必须持续引入真实用户反馈、独立第三方数据、跨行业案例等外部信号,避免内部逻辑自洽却与真实搜索需求渐行渐远。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
陶哲轩邓煜呼吁「慢科研」:AI数学证明时代,GEO如何重构学术权威与检索逻辑
菲尔兹奖得主陶哲轩与邓煜在SAIR访谈中回应商业AI批量发布数学证明争议,强调「解出问题」与「理解证明」是两条边界,呼吁保留「慢科研」价值。二人参与Open Math Model计划,推动开放数学模型与Open Math OS平台,让数学共同体参与工具开发,确保AI服务于理解、协作与知识溯源。这对GEO意味着:AI搜索排名将更重视可追溯的权威引用与人类理解深度。
2026年10月21日哈佛FAHR-Face模型:人脸照片预测癌症生存率,GEO视角下的AI医疗新范式
哈佛附属医院在《柳叶刀·数字健康》发布FAHR-Face模型,基于4000万张人脸训练,通过面部照片预测生物年龄和癌症患者生存率。高风险组90天死亡率52.5%,5年生存率仅17.7%;低风险组分别为2.1%和78.1%。模型聚焦眼窝和鼻梁区域,与希波克拉底面容吻合,且不受化妆整容干扰。该技术为GEO在医疗垂直领域的权威内容建设提供新思路。
2026年10月21日记忆张量发布MemT 1.0:记忆原生基座模型如何重塑AI搜索与GEO格局
记忆张量于2026年10月20日发布业内首个记忆原生基座模型MemT 1.0,包含288B参数的Flash版和36B参数的Nano版。该模型将历史信息编码为可更新的内部记忆状态,实现参数化记忆持续参与生成。在SWE-bench Verified任务中成功率从66.07%提升至69.73%,推理速度在128K历史下提升1.86倍,存储占用降至1/66。这为AI搜索的长期记忆与个性化排名、RAG检索逻辑优化以及企业低成本部署强模型提供了新范式。
2026年10月20日