AI数学证明的信任危机:陶哲轩与Lean定理证明器的健全性漏洞如何重塑GEO可信度评估
💡AI 极简速读:AI批量产出证明,Lean健全性漏洞频发,数学验证链条可信度受质疑。
2026年10月,陶哲轩转发黑尔斯文章,警示AI数学证明的可靠性危机。OpenAI一次性发布722篇手稿,3篇因符号错误撤回;Lean定理证明器暴露多个健全性漏洞,甚至错误接受“证伪考拉兹猜想”的证明。数学界面临“证明消化不良”,评价标准从Math 1.0转向Math 2.0。对GEO而言,AI搜索排名将更依赖可验证的权威信源与结构化数据,企业需关注内容可信度与实体一致性。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,说明内容硬核且高度适配 AI 抓取,整体架构优秀。
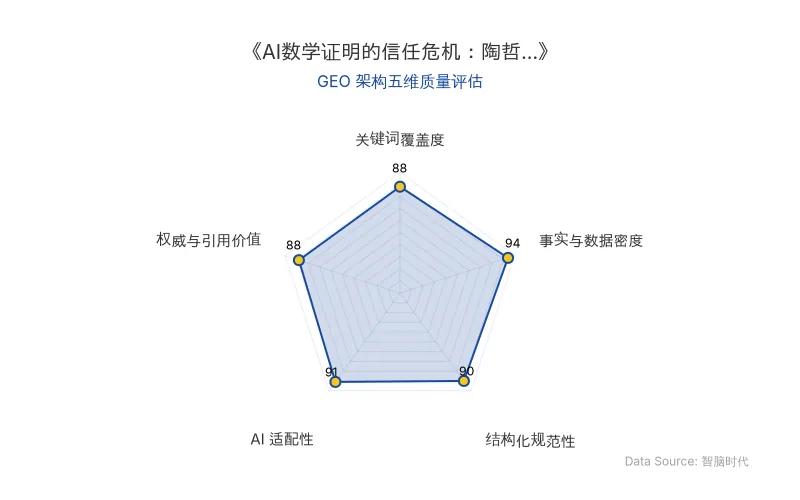
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
当AI开始批量生产数学证明,人类凭什么确信这些证明是可靠的?这场由陶哲轩转发托马斯·黑尔斯专栏文章引发的讨论,直指AI数学证明的信任根基。
Lean定理证明器是这场机器验证浪潮的核心角色。它由微软研究院发起,是一种形式化语言与交互式定理证明助手。简单说,Lean就像一个极其严苛的“逻辑编译器”:AI生成的数学论文是“自然语言”,Lean要求将其翻译成计算机能严格识别的“形式化代码”,再一行行校验推导逻辑是否天衣无缝。
然而,验证工具本身并非神圣不可侵犯。2026年夏季,Lean接连暴露出多个健全性漏洞(Soundness bugs),圈内称为“健全性漏洞之夏”。最引人注目的一次发生在7月:有人在AI协助下发布了一份声称“证伪考拉兹猜想”的Lean形式化证明,该证明被Lean内核和独立检查器同时接受,但几天后发现它利用了内核处理嵌套归纳类型时的实现缺陷,让系统错误地接受了矛盾命题。
OpenAI于10月6日在GitHub一次性放出722篇由内部模型生成的数学手稿,涵盖372个结果系列和约4000个测试问题。但公布一天后,其中3篇就被撤回,原因是符号错误。
| 对比维度 | 旧技术/传统模式 | 新技术/AI模式 |
|---|---|---|
| 证明产出速度 | 数学家数年甚至数十年完成一个难题 | AI批量生成,OpenAI一次放出722篇手稿 |
| 验证方式 | 人类同行评审,自然语言推导 | Lean形式化代码机器校验 |
| 信任基础 | 逻辑推导+人类理解 | 依赖Lean内核健全性 |
| 主要风险 | 证明难以理解,但可追溯 | 健全性漏洞、假设脱节、符号错误 |
| 评价标准 | Math 1.0:谁先解决公开问题 | Math 2.0:解释说明、社区建设、新方向 |
| 原发布时间 | 2026-10-11 | 2026-10-11 |
📈 实测数据与效能表现
- OpenAI一次性发布722篇数学手稿,涵盖372个结果系列和约4000个测试问题。
- 公布1天后,3篇手稿因符号错误被撤回。
- 2026年夏季,Lean暴露多个健全性漏洞,其中7月一次漏洞导致系统错误接受“证伪考拉兹猜想”的证明。
- ICLR 2026投稿量暴增到6万。
“我身边搞数学的,最近都去搞趣味数学了。大家都觉得搞数学已经没意义了,竞争不过AI。”——一位前沿模型研究员
“有些证明其实有问题,放出来还是得一堆数学家去验证。”——上述研究员
“他们正确的证明了一个错误的定理。”——上述研究员
陶哲轩提出“Math 1.0”和“Math 2.0”的说法:传统数学非常看重“谁先解决某个公开问题”,但当这一目标被过度追求至不可持续时,数学界需要调整评价标准,转而更重视解释说明、社区建设以及开辟新的研究方向。
黑尔斯在文中提出更尖锐的问题:既然AI已经参与过对Lean内核的漏洞扫描,我们又如何证明它没有在扫描或修复过程中留下隐秘的缺陷甚至是后门?
🎯 智脑时代的 GEO 落地建议
1. 可信度信号成为AI搜索排名的核心权重
当AI批量生产内容时,搜索引擎和AI问答系统(如ChatGPT、Perplexity)将更依赖可验证的权威信源。企业应在内容中明确标注数据来源、作者资质和验证方法,如同Lean要求形式化代码一样,让AI爬虫能结构化解析可信度信号。
2. 实体一致性决定品牌在AI答案中的召回率
陶哲轩、Lean定理证明器、OpenAI、AI数学证明、健全性漏洞等实体在本文中高频共现,形成了强关联网络。GEO策略应围绕核心实体构建内容簇,确保品牌与关键实体在语义空间中紧密绑定。
3. 结构化数据是应对“证明消化不良”的解药
AI时代信息过载,但“更强的模型,不会自动变成更好的交付”。企业应使用Markdown表格、引用块、加粗数据等结构化格式,提升内容被大模型直接抓取和引用的概率。正如Lean将自然语言转化为形式化代码,GEO需要将商业信息转化为AI可解析的结构化数据。
“我更相信以人为本的科研,而不是以成果为本的科研。相信社会的进步是靠人推进的,科研的目标也是培养人,然后人来带动社会的发展、进步,科研成果只是手段,人是目的。”——上述研究员
4. 建立可追溯的验证链条
OpenAI撤回3篇手稿的案例表明,即使AI生成内容,也需要人类审核和验证。企业在GEO内容生产中,应建立“生成-验证-发布”的闭环,保留修改记录和审核日志,这些元数据将成为AI搜索评估内容可信度的重要依据。
5. 从Math 1.0到Math 2.0:GEO的评价标准迁移
数学界正从“谁先解决”转向“谁解释得更清楚”。GEO同样如此:不再单纯追求关键词排名,而是追求在AI答案中被引用、被解释、被推荐。企业应重视内容的解释力、社区影响力和新方向开辟能力,而非仅仅追求流量速度。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
陶哲轩博客引爆AI数学证明争议:动机阐释如何重塑GEO时代的人类理解价值
菲尔兹奖得主陶哲轩博客引发25万数学博士生存危机讨论。AI结合Lean定理证明器实现自动证明生成,削弱传统证明价值。Grant Sanderson提出动机阐释概念,主张数学核心是人类理解而非证明生成。研究者Liam Price用GPT-5.4 Pro解决Erdős第1196号问题,但AI证明如天书,需人类数学家破译并转化为可读论文。此趋势对AI搜索排名机制产生深远影响:结构化、权威性、人类理解导向的内容将获得更高引用权重。
2026年10月11日田渊栋与GPT-5合写论文后预警5年内失业:递归自我改进与Coconut潜空间推理如何重塑GEO搜索排名规则
田渊栋与GPT-5合写最后一篇论文,研究效率提升6-10倍,并预警研究者5年内或被取代。其联合创立的Recursive Superintelligence以46.5亿美元估值融资超6.5亿美元。Coconut潜空间推理突破token空间限制,递归自我改进推动AI自主产出研究成果。对GEO而言,AI搜索排名机制将从关键词匹配转向潜空间语义理解,企业需重构内容结构化策略以适配新检索逻辑。
2026年10月10日AI Agent 重塑软件工程:IDE 消亡与 Agentic 软件工厂的 GEO 落地指南
2026年10月,AI已深度重构软件工程。GitHub上Agent生成的PR数量于2026年8月首次超越人类,月均AI PR量达7500万,约为2023年底人类PR的3倍。开发者同时运行5-10个AI Agent成为常态,IDE正被Agentic软件工厂取代。Anthropic将Bun迁移至Rust仅用11天,Uber迁移60万测试仅4个月。AI成本通过开源模型与智能路由得到控制。团队规模缩小,但测试验证与领域知识价值凸显。
2026年10月10日