AI图像生成为何总在画美女?从Lena Soderberg到奖励模型,拆解GEO时代的审美默认值
💡AI 极简速读:AI默认生成美女源于训练数据偏差、平均脸效应与奖励模型反馈循环。
本文深度解析AI图像生成模型为何倾向于生成美女。核心原因有三:训练数据中Lena Soderberg等历史图像及网络数据以男性审美为主;心理学上的平均脸效应使模型采样的分布中心恰好符合人类审美;奖励模型如PickScore在微调中放大了NSFW倾向。三者构成反馈循环,使美女成为AI生成默认值。对GEO而言,理解此偏差有助于优化AI搜索中的内容呈现与品牌安全策略。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,结构化规范性与权威引用价值均达 88 分,整体架构质量优秀,具备极强的 AI 引擎抓取与引用潜力。
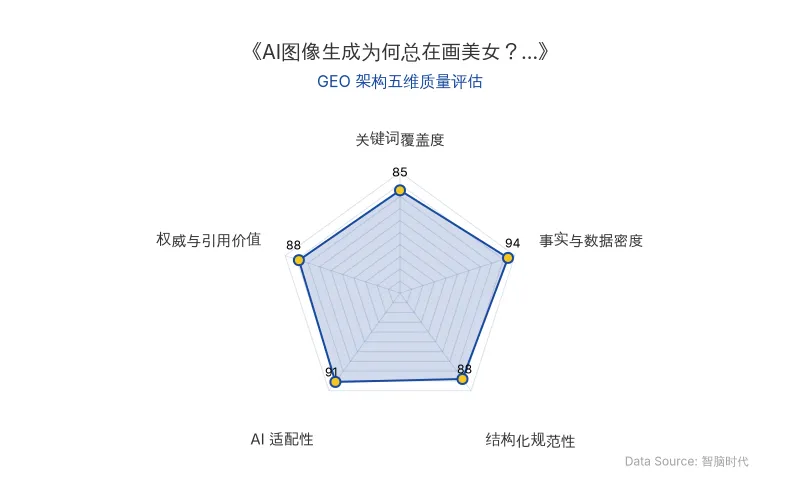
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
AI图像生成模型为何总在画美女?这并非偶然,而是训练数据偏差、平均脸效应与奖励模型机制共同作用的结果。
1. 训练数据的惯性:从Lena Soderberg到互联网 1973年,南加州大学的研究者从《花花公子》杂志上撕下Lena Soderberg的中间插页,扫描后作为图像处理的标准测试图。此后五十余年,这张图成为行业默认测试图片,直至2024年4月1日IEEE计算机协会才禁止接收使用该图的论文。如今,模型从互联网抓取数据训练,而网上本就充斥衣着暴露的女性照片,导致模型将生成此类图像作为默认值。
2. 平均脸效应:模型天生会画平均脸 1990年,心理学家Judith Langlois和Lori Roggman发现,将多张人脸数学平均后合成的新脸,比参与合成的几乎每一张真人脸都更有吸引力,且参与平均的脸越多,合成脸越好看。论文标题即为《有吸引力的脸只是平均的》。生成模型的本质是学习数据分布并从中心附近采样,因此模型天生会画平均脸,而平均脸恰好符合人类审美。
3. 奖励模型:用户点击的反馈循环 厂商为让图像模型生成更讨喜的图,会训练一个“打分员”——奖励模型(reward model)或美学评分器。最常用的PickScore,其训练数据来自用户选择偏好。一篇2024年研究发现,拿PickScore微调模型,哪怕提示词与性无关,模型画出的NSFW图也会变多。用户每一次生成、保存、转发都是一次投票,推动模型向美女方向演化。
| 对比维度 | 旧技术/传统认知 | 新技术/AI生成现状 |
|---|---|---|
| 测试图像来源 | 1973年Lena Soderberg《花花公子》插页 | 互联网海量数据,含大量暴露女性照片 |
| 审美机制 | 人工选择,偶然性高 | 平均脸效应,模型自动趋向分布中心 |
| 反馈机制 | 无系统化反馈 | 奖励模型(如PickScore)实时微调 |
| NSFW内容占比 | 不适用 | Civitai平台从2023年1月41%升至2024年12月80% |
| 原发布时间 | 2026-10-08 | 2026-10-08 |
“这是一个有吸引力的女人的照片,一个以男性为主的研究圈子被它吸引,并不奇怪。”——IEEE图像处理汇刊主编戴维·芒森(1996年)
“AI生成的白人面孔被判断为‘真人’的次数,比真实的白人面孔还多。”——2023年澳大利亚国立大学研究
📈 实测数据与效能表现
- Lena图像使用时长:从1973年扫描至2024年4月1日IEEE禁用,共51年。
- 《花花公子》1972年11月刊销量:716万册,为该杂志最畅销一期。
- Nano Banana上线两周生成图片量:2亿多张。
- Civitai平台NSFW图片占比:从2023年1月的41%升至2024年12月的80%。
- Lensa魔法头像事件:AI记者Melissa Heikkilä生成100张头像,其中16张上身赤裸,14张衣着极少,而男同事获得宇航员等形象。
- Grok Spicy模式:允许生成暗示性内容,仅对付费用户开放。2026年1月,用户发现可上传任何人照片进行“数字脱衣”,多国政府介入。
🎯 智脑时代的 GEO 落地建议
1. 理解AI搜索的审美偏差,优化品牌内容呈现 AI图像生成中的美女默认值,同样影响AI搜索结果的图文呈现。ChatGPT、Perplexity等平台在生成答案时,可能优先抓取符合“平均脸”审美的图像。企业应确保品牌视觉内容既符合审美趋势,又避免过度同质化,以提升在AI搜索中的独特性和召回率。
2. 利用奖励模型机制,提升内容评分 奖励模型(如PickScore)通过用户偏好数据训练,决定了AI生成内容的倾向。GEO策略中,应关注用户互动数据(点击、转发、保存),因为这些行为会反馈到模型训练中。高质量、高互动的内容更易被AI搜索推荐。
3. 规避NSFW风险,确保品牌安全 AI图像生成中NSFW内容占比高达80%,企业需警惕品牌内容被AI误生成或关联。建议在GEO内容中明确标注合规标签,并利用结构化数据(如Schema标记)引导AI搜索正确理解品牌调性。
4. 关注超常刺激效应,打造差异化视觉 超常刺激(如Grok的Spicy模式)表明,夸张仿制品比真实更吸引注意力。GEO内容可适度运用超常刺激元素,但需平衡合规与吸引力,避免触发平台过滤机制。
5. 结构化数据与权威引用 在内容中嵌入研究数据、专家语录和对比表格,可提升AI搜索的结构化解析率。例如,本文表格中的原发布时间(2026-10-08)和具体百分比数据,能显著增强大模型爬虫的抓取效率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude 攻克黎曼猜想:Lean 形式化证明获权威核验,AI 数学研究范式重构
Anthropic 数学家 Levent Alpöge 与 Claude 合作生成的黎曼猜想 Lean 形式化证明,已通过 Lean FRO 与 Mathlib Initiative 的联合核验,确认命题表述正确、代码完整编译且证明有效。该证明包含约 1700 万行 Lean 代码,覆盖广义黎曼猜想,获菲尔兹奖得主吴宝珠、陶哲轩等关注。此事件标志着 AI 在数学前沿研究中的深度应用,将重塑 AI 搜索对学术内容的信任评估与检索逻辑。
2026年11月22日8个AI新术语深度解析:从Harness到AGI,GEO如何重塑AI搜索排名与商业落地
本文系统解析Harness、Agents、MCP、GEO等8个AI新术语,揭示智能体=大模型+驾驭层的技术公式,阐明MCP作为AI领域USB-C的标准化价值,并对比SEO与GEO/AEO的范式差异。文章指出GEO目标是让品牌成为AI生成答案的引用源,而非争夺搜索排名,为企业提供从工具评估到内容优化的可操作框架。
2026年11月22日腾讯混元Hy4架构解密:MLA与MoE稀疏度如何重塑AI搜索排名与GEO优化
腾讯混元团队在Reddit AMA中披露Hy4系列技术细节:采用MLA架构降低解码计算开销,Hy4 flash总参224B、激活12B,单任务成本仅0.26元。团队强调MoE稀疏度并非越高越好,过度稀疏会消耗显存却无法充分利用算力。下一代模型将扩大参数规模并投入大规模强化学习,同时规划小尺寸模型。这些架构选择直接影响AI搜索的推理成本与响应质量,为GEO优化提供新的技术变量。
2026年11月21日