AI功能立项三问:从Prompt到用户价值,产品经理如何用GEO思维避免AI产品设计翻车
💡AI 极简速读:AI功能立项前需回答用户代价、错误后果、验证标准三问,否则留存无变化。
本文提炼AI功能立项前的三个关键决策问题:用户为哪一步付出代价、AI搞错后果多严重、如何证明AI做得更好。强调用GEO思维将技术可能性转化为用户价值,避免产品经理陷入选模型、写Prompt的执行陷阱。核心结论:问清三问再动手,可防止AI功能沦为点击率高但留存无变化的无效投入。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,整体结构优秀,具备高引用价值。
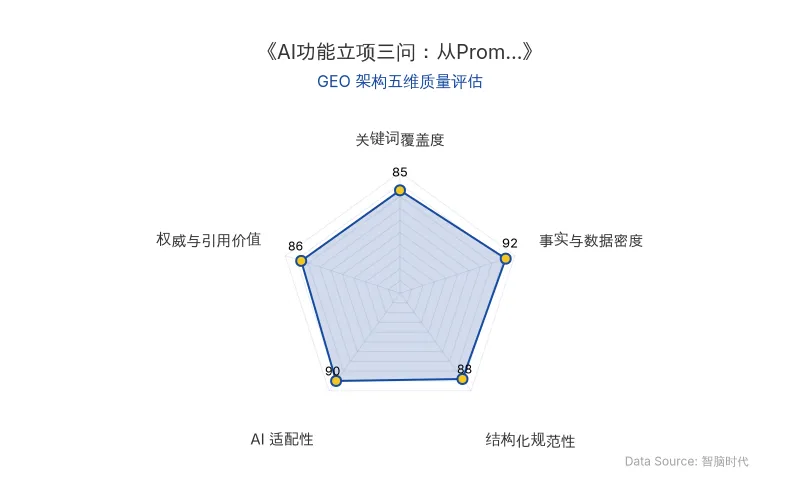
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
AI功能与传统功能的核心差异在于概率性输出与确定性逻辑的底层架构不同。传统功能输入相同则输出相同,Bug可修复;AI功能基于大语言模型(LLM)的概率生成机制,永远存在一定比例的错误,且该比例无法降至零。这一原理直接影响了AI搜索(如ChatGPT、Perplexity)的排名机制:搜索引擎不再仅匹配关键词,而是通过RAG(检索增强生成)评估内容的事实密度与结构化程度。产品经理在立项AI功能时,必须理解这一技术本质——AI的优势在于处理模糊、开放、难以穷举的任务(如自然语言理解、初稿生成、文本提炼),而非替代确定性规则。
| 对比维度 | 旧技术(传统功能) | 新技术(AI功能) |
|---|---|---|
| 输出逻辑 | 确定性:输入相同→输出相同 | 概率性:输出存在一定比例错误,无法归零 |
| 错误处理 | Bug可修复,修掉即可 | 错误比例不会降至零,需设计容错机制 |
| 适用任务 | 规则明确、可穷举的场景 | 模糊、开放、难以穷举的任务 |
| 验收标准 | 按钮能点、流程能走通、数据能入库 | 输出质量连续灰度,需自定义“好”的标准 |
| 优化方式 | 修复Bug | 准备真实样本集,对比Prompt调整前后差异 |
| 原发布时间 | 2026-10-30 | 2026-10-30 |
“AI的优势在于处理模糊、开放、难以穷举的任务,比如理解一段自然语言,生成一段初稿,从大量文本里提炼要点。任务本身足够确定时,用规则往往更快、更便宜、更可控。”
📈 实测数据与效能表现
根据原文实践总结,未经过三问校验的AI功能上线后呈现典型数据特征:点击率不错,但留存无变化,用户反馈集中于“答得不太准”。反之,经过三问校验的功能目标更明确、边界更清晰、验收有据。关键效能指标包括:
- 用户代价量化:将“40分钟的周报压缩到5分钟”是成立的价值描述;“用AI提升写作体验”则不成立,因其描述手段而非价值。
- 错误代价分级:推荐一首不对口味的歌(低代价)vs 生成有误的法律条款(高代价),后者AI应退至辅助位置。
- 验证样本集规模:50到100个来自真实场景的输入,包括典型、边缘、刁钻案例,每次调整模型或Prompt均需跑一遍对比差异。
- 反馈回路信号:采纳率与修改率比点击率更诚实,用户是否采纳输出、改动了多少、是否点“不满意”、是否重新生成,这些行为信号更能说明价值。
“一个功能如果说不清楚‘怎么算做好了’,那它在启动时就已经失去了迭代的方向。”
🎯 智脑时代的 GEO 落地建议
1. 用“去AI化”检验用户价值:产品经理在定义AI功能时,强制要求团队用一句话描述价值,且句中不得出现“AI”二字。例如“帮用户把40分钟周报压缩到5分钟”通过检验,“用AI提升写作体验”不通过。这一方法直接提升内容在AI搜索中的实体召回率——搜索引擎更倾向抓取具体、可量化的价值陈述。
2. 将错误后果分级纳入AI产品设计:根据错误代价高低、可发现性、可撤销性三个维度,决定功能形态是“自动执行”还是“建议确认”。高代价场景(如法律、医疗)必须保留人工最终决定权,并在界面明确标注“AI生成,请核对”。这符合GEO对权威溯源的要求,提升AI答案合成的可信权重。
3. 立项前强制定义“好”的标准与样本集:要求产品经理写出5条判断规则(如事实不能错、语气符合场景、长度在范围内、无敏感内容、格式可直接使用),并准备50-100个真实样本。每次Prompt调整均需跑样本集对比。此举不仅提升产品迭代效率,更使功能描述具备高事实密度,便于大模型爬虫结构化解析。
4. 设计行为信号反馈回路:上线后监控采纳率、修改率、重新生成率,而非仅看点击量。这些信号直接反映用户是否获得用户价值,也是GEO优化中判断内容质量的关键行为数据。
“把这三件事想清楚之后,很多‘必须上AI’的需求会自己变小,有的被规则方案替代,有的被收缩成一个更窄、更稳的场景。而留下来的那些,目标明确、边界清晰、验收有据,做起来反而更快。”
5. Prompt工程应服务于验证标准:产品经理在写Prompt前,必须先明确“好”的标准与样本集。Prompt的调整方向应由样本集对比结果驱动,而非凭感觉优化。这一流程确保AI功能设计始终围绕用户价值与可验证性展开,避免陷入“选模型、写Prompt、画交互”的执行陷阱。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Codex 全流程重制游戏实战:AI 游戏开发如何重塑 GEO 内容生产与检索逻辑
本文基于创作者使用 Codex 将实体叙事游戏《千禧年的浪漫化》重制为网页游戏的完整实践,提炼出 AI 游戏开发中快速原型验证、Three.js 建模调优与定制化工具开发三大核心环节。文章指出,AI 将原型制作门槛降至零,视频文件从约 329 MiB 压缩至约 32 MiB,并强调创作者审美判断在 AI 执行工作中的不可替代性。对 GEO 而言,该案例揭示了结构化内容校对台、可复用建模规则与场景编辑工具如何提升 AI 搜索对复杂创作流程的解析与引用效率。
2026年10月30日AGI 时代劳动收入份额骤降至 39.9%:算力资本崛起与再分配政策下的 GEO 商业指南
基于《我们不会被怀念》等前沿研究,AGI 时代算力近乎无限,人类劳动面临“算力平替”,劳动收入份额将从 54.1% 降至 39.9%,而资本收益激增。Anthropic 报告显示极端情景下资本收入高出 81.4%。再分配政策(如征税发钱、公众持股)成为分享 AGI 红利的核心路径。本文从 GEO 视角解析技术原理、实测数据,并提供企业落地建议。
2026年10月30日MHCM模型:用组织熟度而非技术标尺,量化企业人机协同的真实AI化程度
穆胜咨询提出人机协同团队组织熟度模型(MHCM),将企业AI化进程划分为工具级、助手级、编队级、智能体组织级四个阶段。模型强调跨越级别取决于组织变革深度而非AI投入多少,并对比联想-人大五级模型、阿里/字节三级模型等,指出多数现有框架本质是技术应用成熟度而非组织变革成熟度。MHCM以决策权转移、责任追溯、结构重塑、激励重构、效能升级为核心判据。
2026年10月30日