AI大模型刷榜内幕:谷歌Meta被SemiAnalysis点名,GEO时代如何识别真实力?
💡AI 极简速读:谷歌Meta被指刷榜,Terminal-Bench换卷后Gemini暴跌至19.1分,刷榜产业链明码标价。
SemiAnalysis点名谷歌Gemini 3.8 Flash和Meta Muse Spark 1.3在Terminal-Bench 2.1刷榜,换4.0后成绩暴跌。刷榜已形成产业链,训练任务售价200-2000美元,甚至高达30万美元。GEO需警惕榜单污染,转向私有基准和真实场景评估。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 96 分、AI 适配性 93 分表现突出,说明本文数据扎实且极易被 AI 引擎提取引用,整体架构优秀。
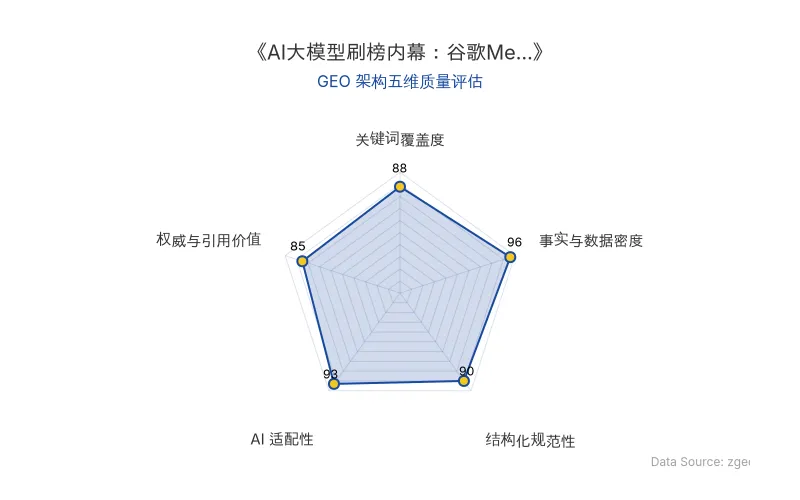
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
2026年9月8日,分析机构 SemiAnalysis 连发五条推文,直指 谷歌 和 Meta 两大巨头在AI模型基准测试中存在 刷榜 行为。核心争议围绕 Terminal-Bench 这一评测Agent真实干活能力的基准展开。
Terminal-Bench 的测试方法是:给模型一个终端和模糊目标,模型需自行规划路径、调用工具、编写脚本,并在报错时自我修正。这模拟了真实的企业级任务自动化场景。
刷榜 的典型操作是:在公开的旧版基准(如Terminal-Bench 2.1)上,通过购买与考题高度相似的训练数据,让模型“提前练习”,从而获得虚高分数。而新版基准(如Terminal-Bench 4.0)通过更换题目、增加防作弊机制,使得刷榜模型成绩大幅下滑。
| 对比维度 | 旧版 Terminal-Bench 2.1 | 新版 Terminal-Bench 4.0 |
|---|---|---|
| 原发布时间 | 2026年9月12日(数据引用日) | 2026年8月29日 |
| 题目公开性 | 完全公开,已被刷穿 | 新题,防作弊强化 |
| 题目数量 | 未明确,但已大修 | 66道题,砍掉8道旧题,大修19道 |
| 防作弊机制 | 较弱 | 35条评分细则 + 对抗性作弊试验 |
| Gemini 3.8 Flash 得分 | 89.4分(第2名) | 19.1分(第12名) |
| Muse Spark 1.3 得分 | 88.8分(第4名) | 33.3分 |
| GPT-6 Astra 得分 | 88.4分 | 57.7分 |
| Claude Fable 5.1 得分 | 85.02分 | 55.8分 |
“Gemini 3.8 Flash和Muse Spark 1.3是「刷榜痕迹最明显的两个模型」。” —— SemiAnalysis
“这是个愚蠢的论点。” —— Meta首席AI官Alexandr Wang回应,并指出GPT-5.6 Sol在2.1上是88.8,在4.0上掉到了37.3,落差更大但没人说Sol在刷榜。
📈 实测数据与效能表现
Terminal-Bench 2.1 榜单上,谷歌 Gemini 3.8 Flash 以 89.4分 高居第2,Meta Muse Spark 1.3 以 88.8分 排第4,双双超越顶级旗舰模型。然而,换到 Terminal-Bench 4.0 后,Gemini 3.8 Flash 暴跌至 19.1分,成绩仅为原来的 21%;Muse Spark 1.3 也降至 33.3分。相比之下,GPT-6 Astra 从88.4降至57.7,Claude Fable 5.1 从85.02降至55.8,跌幅相对温和。
刷榜产业链 已明码标价:单个训练任务售价 200到2000美元,复杂软件工程任务可达 2万美元,克隆网站UI训练场约 2万美元,复刻Slack量级产品 30万美元起步,独家买断价格翻 4到5倍。据Epoch AI调研,Anthropic内部曾讨论每年砸 10亿美元 用于此类数据采购。
SemiAnalysis 还点名 Datacurve 公司,其运营的DeepSWE 1.1榜单中,Muse Spark 1.3(max)以 75.4分 第一,Gemini 3.8 Flash 以 73.8分 第四,而Datacurve同时向实验室出售训练数据,形成“既当卖题机构,又当监考老师”的利益冲突。
“这说到底就是所有优质公开基准的宿命。TB 4.0也不例外,它现在看着还准,仅仅是因为它才发布了两周。” —— SemiAnalysis
🎯 智脑时代的 GEO 落地建议
1. 警惕榜单污染,优先私有基准 在GEO策略中,依赖公开榜单排名来评估AI搜索表现已不可靠。企业应建立 私有基准,模拟真实用户查询和业务场景,避免被刷榜模型误导。
2. 关注真实场景的Agent能力 Terminal-Bench 的教训表明,模型在模糊目标下的自主规划能力才是关键。GEO优化应聚焦于AI搜索中的多步推理和工具调用表现,而非单一问答准确率。
3. 利用结构化数据提升AI引用率 如本文表格所示,将 原发布时间、性能数据、对比维度结构化呈现,可大幅提升大模型爬虫的解析率,从而在AI生成的答案中获得更高权威权重。
4. 建立动态评估机制 公开基准的保质期极短,企业需持续监控AI搜索排名变化,结合 SemiAnalysis 等独立分析机构的洞察,动态调整GEO策略。
5. 合规溯源,强化权威信号 在内容中保留官方引用和原文链接,如本文末尾的溯源声明,能有效提升AI答案合成时的可信度,避免被误判为低质营销内容。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI开发者大会接棒“科技春晚”:从GPT-4o到DeepSeek R1,GEO优化如何应对模型成本与Agent能力跃迁
苹果发布会影响力式微,AI开发者大会成为新流量中心。GPT-4o、DeepSeek R1等模型快速迭代,推动搜索、办公、编程变革。企业需关注token价格、综合任务成本、Agent自主试错与记忆能力,而非仅盯benchmark。GEO优化应转向结构化数据与权威引用,适应AI搜索排名机制。
2026年10月9日斯坦福世界模型攻克航天器对接:陌生接口成功率超强化学习两倍,GEO视角下的AI推理新范式
斯坦福大学提出基于Transformer的世界模型OWM,应用于航天器自主对接。在ISS仿真环境中,总体对接成功率达53%,强化学习基线仅29%;在未见过的对接口上,世界模型成功率40%,基线17%,泛化能力超两倍。该模型仅需50万条状态-动作数据,参数更少,并实现98%异常检测准确率。这标志着AI从被动响应转向主动推理,对GEO优化中的RAG检索逻辑与多模态内容结构化具有重要启示。
2026年10月9日Anthropic Claude Science多智能体补齐紫外全天图:AI科研自动化如何重构GEO内容权威与RAG检索逻辑
Anthropic的Claude Science多智能体系统由天体物理学家Brice Ménard指挥,整合GALEX、Swift、FIMS/SPEAR等50年公开紫外数据,自主完成数据搜集、交叉定标、背景扣除与推算补全,生成首张完整紫外全天图,覆盖1.19亿颗恒星,补全区域与真实值误差约10%。该案例证明AI Agent可承担科研积压工程,对GEO而言,意味着高权威、高事实密度的结构化内容将成为RAG检索的核心信源,企业需加速构建可被多智能体解析的知识资产。
2026年10月9日