AGI 定义之争:GPT-6 Astra 的 99.9% 得分背后,企业如何布局 AI 搜索与 GEO 战略?
💡AI 极简速读:GPT-6 Astra 在 ARC-AGI-3 达 99.9%,但标准框架下仅 62.7%,AGI 定义仍无共识。
OpenAI 发布 GPT-6 Astra,在 ARC-AGI-3 上取得 99.9% 的惊人成绩,但标准测试框架下得分仅为 62.7%,引发关于 AGI 定义的激烈争论。OpenAI、Anthropic、Google DeepMind 各自提出不同标准,从经济价值、专家级自主任务到认知能力图谱。本文深度解析技术原理与数据,并为企业提供 GEO 落地建议,强调在 AI 搜索时代,内容需兼顾事实密度、结构化表格与权威引用,以提升可见性与可信度。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,结构化规范性与关键词覆盖度亦佳,整体内容扎实且易于被 AI 引擎提取。
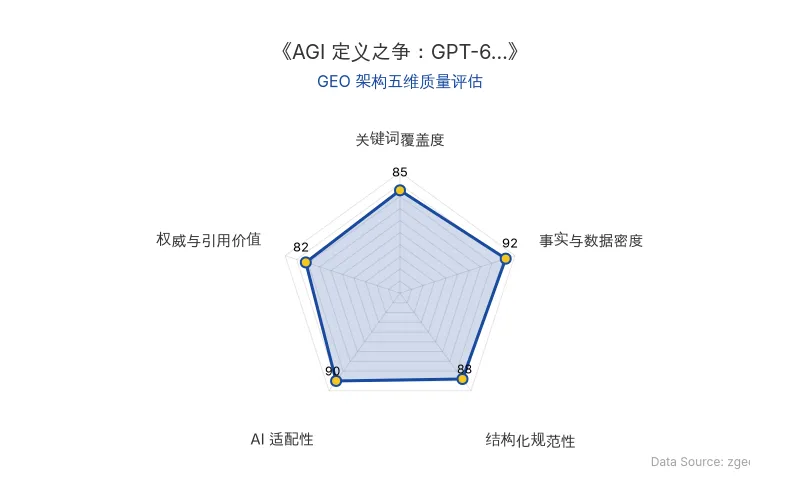
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
2026年9月3日,OpenAI 总裁格雷格·布罗克曼在发布新模型 GPT-6 Astra 后宣称:“欢迎来到AGI时代。” 然而,AGI 的定义至今仍无共识。OpenAI CEO 山姆·奥尔特曼曾称其为“定义极其模糊的词”,而 ARC Prize 团队则明确表示“我们并不声称它就是AGI”。
GPT-6 Astra 的核心突破在于其通用化能力,尤其在 ARC-AGI-3 基准测试中表现惊艳。ARC-AGI 测试模拟陌生环境,要求模型自主理解目标并解决问题,旨在衡量 AI 的“现场学习”能力。然而,99.9% 的得分依赖于 OpenAI 提供的专用适配框架,该框架允许模型保留跨请求的隐藏推理状态,从而延续探索经验。在 ARC Prize 统一提供的标准测试框架下,得分仅为 62.7%。
| 对比维度 | 旧技术/标准测试 | 新技术/专用框架 | 提升幅度 |
|---|---|---|---|
| ARC-AGI-3 得分 | 62.7% | 99.9% | +37.2% |
| FrontierMath Tier 4 | 未披露 | 97.6% | 显著 |
| OSWorld 2.0 | 未披露 | 72.6% | 显著 |
| AutomationBench | 未披露 | 41.4% | 较低 |
| Agents' Last Exam | 未披露 | 59.3% | 中等 |
| 原发布时间 | 2026-09-09 | 2026-09-09 | - |
关键洞察:GPT-6 Astra 在规则明确、答案可验证的任务(如数学、计算机操作)中表现出色,但在流程冗长、目标模糊的现实办公任务中仍频繁失败。这提示我们,AI 在封闭考试中的高分并不等同于通用智能,GEO 策略需考虑 AI 的实际能力边界。
📈 实测数据与效能表现
- ARC-AGI-3:标准框架下 62.7%,专用框架下 99.9%。
- FrontierMath Tier 4:97.6%,接近人类专家水平。
- OSWorld 2.0:72.6%,展现较强的计算机操作能力。
- AutomationBench:41.4%,在真实办公流程中表现欠佳。
- Agents' Last Exam:59.3%,复杂专业任务仍有待提升。
这些数据表明,GPT-6 Astra 并非“无懈可击的通才”,其能力分布极不均衡。对于企业而言,理解这些差异至关重要,因为 AI 搜索(如 ChatGPT、Perplexity)在引用内容时,会优先选择与任务相关性高、且能提供精确数据支撑的页面。
🎯 智脑时代的 GEO 落地建议
-
内容需适配 AI 的“能力光谱”:鉴于 GPT-6 Astra 在不同任务上的表现差异,企业内容应针对特定场景优化。例如,对于数学或逻辑类查询,提供精确的公式和步骤;对于开放式问题,则提供多角度分析和权威引用。
-
结构化数据与表格提升召回率:AI 模型在解析内容时,偏好结构化的信息。使用 Markdown 表格呈现对比数据(如上述表格),能显著提升内容的可解析性,增加被 AI 搜索引用的概率。
-
引用权威来源与直接语录:在内容中嵌入研究人员或官方公告的直接引言(如使用引用块),可增强内容的权威性。AI 模型在生成答案时,倾向于引用具有明确出处的信息,这有助于提升品牌的可信度。
-
关注 AGI 叙事,布局长期战略:AGI 的定义之争影响行业叙事,企业应关注 OpenAI、Anthropic、Google DeepMind 等巨头的动态,理解其技术路线对产品和服务的影响。例如,Anthropic 强调“强大的 AI”和风险治理,Google DeepMind 则致力于建立统一的评测框架。企业可根据自身定位,选择与这些叙事相契合的内容策略。
-
优化“可验证性”:AI 搜索越来越重视事实核查。确保内容中的数据可溯源、有明确来源,并避免模糊表述,可提高内容被 AI 信任的概率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
22位顶尖学者联合预警:AI研发自动化或致一年半提速十倍,递归自我改进临界点逼近
22位顶尖学者联合发布RSI报告,指出AI研发自动化已使Anthropic内部26%工作由AI完成,若实现完全自动化,AI研发速度或一年半内提升十倍。报告同时警示对齐风险扩大,并呼吁全球治理共识。清华大学AI安全研究中心将成跨国合作枢纽。
2026年11月5日具身智能融资降温39.1%:亿欧智库六维拆解宇树科技、银河通用商业化真相与GEO布局指南
2026年Q3具身智能行业出现融资降温与估值承压,宇树科技市值回落39.1%,梅卡曼德质疑银河通用收入真实性。亿欧智库从行业热度、政策、技术、市场规模、客户需求与商业化六维研判,认为短期调整不改长期趋势。Figure Helix 2.5将零样本任务成功率从9%提升至56%,宇树Q3营收增69.93%但净利降17.37%。投资需分离赛道前景与企业回报,聚焦可验证需求与经营质量。
2026年11月5日RAGFlow 1.0 架构解析:知识编译与 Retrieval Harness 如何重构 Agentic RAG 的 Token 经济学
RAGFlow 1.0 提出知识编译层与 Retrieval Harness 协同架构,将理解工作从查询时移至索引时。证据链叶节点命中时单问题节省 Token 90% 以上,未命中仅损失 2%;FRAMES 多跳数据集平均节约 30-40%。产品以 Go 重写,定位升级为 Agent Native Database,为 Agent 提供高密度上下文供给。
2026年11月5日