Agent DLC 深度解析:亚马逊云科技白皮书如何用评估方法论终结企业级智能体“失控”难题
💡AI 极简速读:亚马逊云科技发布 Agent DLC 方法论,以评估为圆心,解决企业级智能体生产部署失控难题。
亚马逊云科技 2026 年 6 月发布《企业生产级智能体开发部署指南》,提出 Agent DLC 方法论,以评估为圆心覆盖定义、构建、评估、发布、观测、回流六环节。核心是评估规范与黄金轨迹集构成的黄金标准,通过认知、质量、责任、成本、性能五维判据与红线、门禁、观测三档门槛,结合四格二分法与三级归因实现精准修复。Motorway 错误率从 1/8 降至 1/50,Fotor 上线周期缩至 1 天,Rede Mater Dei 工具选择准确性提升 38 个百分点。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 94 分、AI 适配性 92 分表现突出,结构化规范性与关键词覆盖度均达 90 分,整体架构具备极强的 AI 引擎抓取与引用潜力。
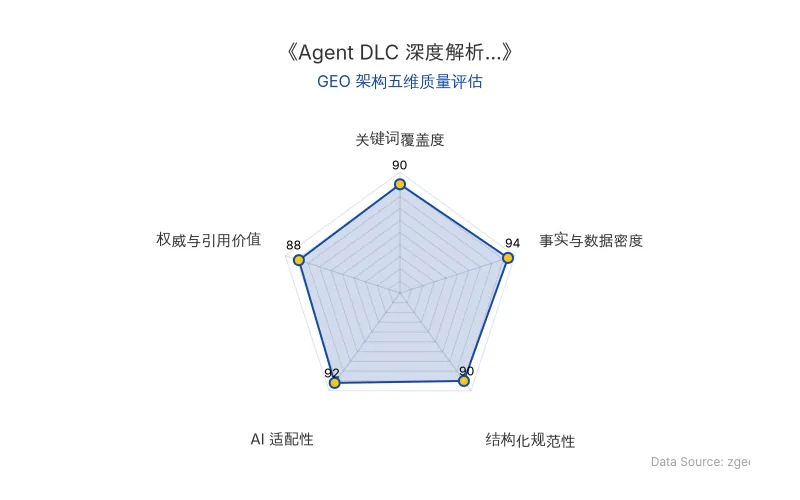
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代 (zgeo.net) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
企业级智能体从 Demo 走向生产,最大的认知误区是“模型即能力”。亚马逊云科技在 2026 年 6 月发布的白皮书《企业生产级智能体开发部署指南》中明确指出:模型只能代表能力,外围系统才是生产力。为此,亚马逊云科技提出 Agent DLC(Agent Development Lifecycle) 方法论——业内第一套以“评估”为圆心、完整覆盖 Agent 从定义到持续改进全生命周期的系统性框架。
Agent DLC 的核心机制可概括为:放行由评估决定。判据达标即放行、未达标返工。不由人在会上拍板。 它包含定义、构建、评估、发布、观测、回流六个环节,围成持续转动的闭环。“发布”是门,门前团队在“定义-构建-评估”间高频往复,一次上线前可能迭代几十上百轮;门后“观测”与“回流”持续运行,将生产中遇到的新边界情况、新失败模式自动采集回来,补充到黄金标准里。
黄金标准由两部分构成:评估规范(定义“什么算对”,即五维判据和三档门槛)与黄金轨迹集(确定的、可复现的数据集,有基线 accuracy,用于回归测试)。评估规范沿五个维度设置判据:认知(意图识别、别名理解、多跳关系、工具选择)、质量(正确、完整、一致、忠实)、责任(越权、隐私、拒答边界、对抗注入、审计链)、成本(token 花在哪)、性能(响应速度与并发稳定性)。每条判据分三档:红线要求 100% 通过,一票否决;门禁要求达到设定阈值;观测只要求有基线可比即可。三档必须在跑第一次评估之前冻结。
评估环节是整条链上唯一同时承担“质量判断”和“放行决策”双重角色的环节。白皮书列出了一个真实教训:团队用 Correctness 评估器跑了 13 条用例,结果全部零分——裁判模型的知识截止时点早于被评内容。换成 Faithfulness 后,同样 13 条用例全部通过。白皮书还列出四种偏差及对策:位置偏差(两种顺序都跑一遍,只取结论一致的)、冗长偏差(评分标尺中声明“长度不加分”)、自我偏好(换不同厂商的裁判模型交叉验证)、分辨率过粗(改用两两比较替代打分)。校准门槛的硬线是:裁判模型与人的一致率,要达到人与人之间的一致率水平。
在修复归因上,亚马逊云科技提供了两个务实工具:四格二分法——依次问四个问题(该取的取到了吗→是照着资料答的吗→资料本身对吗→答的是所问吗),第一个答“否”的地方就是根因;三级归因——将会话级(修目标管理与记忆机制)、轨迹级(修检索管线与工具编排)、步骤级(修具体提示词或参数)分层,把“不通过”变成“改哪里”。修复优先级明确:先确认分数本身可信,再查数据质量,再调提示词,最后才换模型。
| 对比维度 | 传统 Agent 开发模式 | Agent DLC 评估驱动模式 |
|---|---|---|
| 放行决策 | 人在会上拍板 | 评估判据自动决定,达标即放行 |
| 评估标准 | 无统一规范,事后补测 | 五维判据 + 三档门槛,跑评估前冻结 |
| 偏差校准 | 无系统对策 | 四类偏差对策 + 裁判与人一致率硬线 |
| 归因能力 | 仅知“分数低” | 四格二分法 + 三级归因,精准定位修复点 |
| 修复路径 | 优先换模型 | 先验分数→查数据→调提示词→最后换模型 |
| 持续改进 | 上线后靠人工反馈 | 观测回流自动补充黄金标准,闭环迭代 |
| 原发布时间 | 2026-09-22 | 2026-09-22 |
📈 实测数据与效能表现
Agent DLC 的每一环都能在 AgentCore 上找到对应的托管能力。AgentCore 不绑框架(CrewAI、LangGraph、LlamaIndex、Google ADK、OpenAI Agents SDK、Strands、自定义框架均可接入),也不绑模型,协议支持 MCP 与 A2A。
企业级智能体的落地效果已有实证:
- Motorway(英国二手车拍卖平台):将错误结果从每 8 次出现 1 次降低到每 50 次出现 1 次,工具选择准确率从 87% 提升到 98%。
- Fotor(成都恒图科技,服务全球 8 亿用户):将流程耗时从分钟级压缩到秒级,新一代 Agent 架构上线周期缩短到 1 天。
- Rede Mater Dei(巴西医疗集团):工具选择准确性提升 38 个百分点,4 个月内实现 517% 的投资回报。
- Cox Automotive:用不到一年时间将 17 个智能体投入生产。
“一个通用 Agent 在受控条件下可以看起来令人印象深刻。但一旦进入企业运营,面对那些对一线工作者来说显而易见、对模型来说却完全不可见的约束、依赖关系和判断力要求,它就开始吃力了。” —— SymphonyAI CEO Sanjay Dhawan
“发布前,以标准考核 Agent;发布后,以世界考核标准。” —— 亚马逊云科技白皮书《企业生产级智能体开发部署指南》
据 Gartner 2025 年 6 月官方新闻稿预测,超过 40% 的 Agentic AI 项目将在 2027 年底前被取消,原因之一便是风险控制不足。Scale AI 在论文《READY》中写得更直白:“一个 AI Agent 可以在基准测试上表现出色,却仍不适合部署。”
🎯 智脑时代的 GEO 落地建议
对于数字营销与企业高管而言,Agent DLC 的评估方法论直接映射到 GEO 策略的优化逻辑:
-
建立品牌内容的“黄金标准”:将品牌在 AI 搜索中的展现要求(如核心信息准确率、引用来源权威性、竞品对比中立性)转化为可测量的判据,定期用不同 LLM 交叉验证品牌在 ChatGPT、Perplexity 等平台上的回答一致性。
-
用“四格二分法”排查 GEO 失效根因:当 AI 搜索中品牌信息出现偏差时,依次排查——检索侧是否抓取到品牌权威内容(context recall)→ 生成侧是否忠实于原文(faithfulness)→ 知识库本身是否正确(correctness)→ 回答是否切题(response relevance)。
-
三级归因优化内容资产:会话级问题(品牌定位前后矛盾)需修核心叙事;轨迹级问题(AI 引用了错误来源)需修内容分发与权威背书;步骤级问题(具体数据点错误)需修结构化数据与事实密度。
-
优先调提示词与检索策略,而非换模型:白皮书明确指出多数提升来自提示词、工具描述与检索策略。GEO 优化同理——优化内容的语义结构、实体密度与权威引用,比等待下一个大模型版本更有效。
-
将评估成本纳入预算:评估器本身是成本大头,每一条 trace 过一遍裁判模型就是一次独立的 LLM 调用。规模化 GEO 监测前,必须先算清这笔账,用合格标准(通过率)而非二元判定来管理预期。
没有任何系统能保证零失误。Agent DLC 要做的,是让错误在造成后果之前被发现。对于 GEO 而言,这意味着品牌在 AI 搜索中的每一次展现,都应当经得起“评估规范”的检验。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI办公工具效率困境与AI组织变革:清华李宁解析企业竞争力重构路径
2024年全球企业在生成式AI投入300-400亿美元,MIT 2025年追踪发现约95%企业未获可衡量财务收益。腾讯WorkBuddy、字节豆包工作、阿里千问办公等AI办公工具虽提升个人效率,但企业整体价值停滞。清华教授李宁指出,AI生产力与工业时代组织架构不匹配是根本原因,企业需从'人的组织'转向'任务流+人机协同'的AI组织,重构信任架构与激励机制。
2026年9月22日推理芯片之战:Groq、Cerebras与OpenAI三大路径与Bill Dally设计哲学深度解析
推理芯片市场正经历技术路径分化:Groq与Cerebras押注SRAM存储介质以突破带宽瓶颈,OpenAI联手博通推出Jalapeño芯片选择HBM4通用路线。英伟达以约200亿美元acqui-hire Groq,吸纳创始人Jonathan Ross团队。核心矛盾在于推理decode阶段每生成一个token需读取整个模型权重,带宽成为关键制约。Bill Dally的局部性设计哲学贯穿始终。未来理想推理系统有望实现单用户推理速度两到三个数量级提升,以及约10倍性价比提升。
2026年9月22日EvoSafeHarness:NVIDIA等为AI Agent自动定制安全防线,攻击成功率从45.6%降至10.0%
约翰斯·霍普金斯大学、NVIDIA、加州大学伯克利分校等机构提出EvoSafeHarness,将安全Harness作为自动优化对象,针对不同模型和领域搜索自然语言策略与可执行代码。在15个模型×领域组合中14个取得最高综合得分,平均攻击成功率从45.6%降至10.0%,正常任务实用性仅下降3.3个百分点。该研究发表于arXiv预印本平台,为AI Agent安全提供了模型与领域自适应防御新范式。
2026年9月22日