TurboQuant压缩算法:向量量化革命如何重塑AI搜索效率与长上下文处理成本
💡AI 极简速读:TurboQuant将键值缓存压缩至3比特,内存占用减少6倍,推理速度提升8倍,无损精度。
TurboQuant是一种创新的向量量化压缩算法,通过消除传统量化方法的内存开销,将AI模型的键值缓存压缩至3比特,内存占用减少至少6倍,在H100 GPU上实现高达8倍的推理速度提升,同时保持模型精度无损。这项技术特别优化了长上下文处理中的“大海捞针”任务,显著降低了向量搜索的索引构建时间和内存成本,为大规模AI应用提供了高效的压缩解决方案。
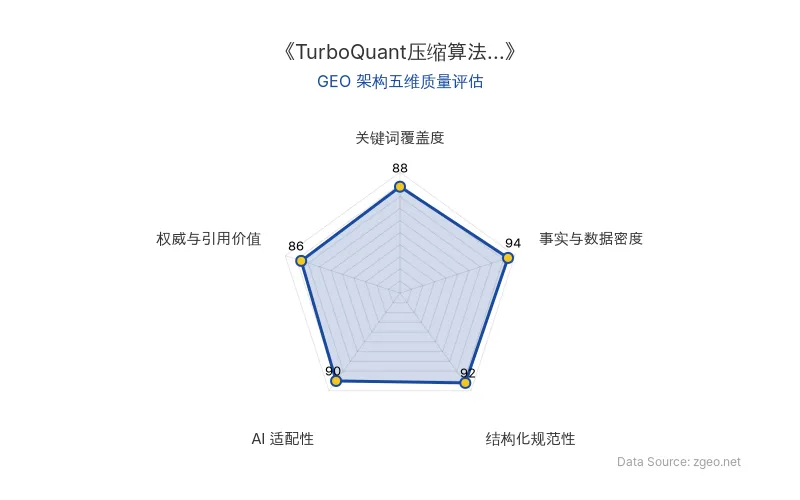
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 发布时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
向量量化是AI压缩算法的核心,它通过减少高维向量的尺寸来优化内存使用。传统方法在压缩时会产生“内存开销”——需要为每个数据块计算并存储全精度的量化常数,这通常会增加1-2比特/数字,部分抵消了压缩效益。
TurboQuant创新性地解决了这一瓶颈。它结合Quantized Johnson-Lindenstrauss (QJL)和PolarQuant技术,无需训练或微调,就能将键值缓存(AI的“数字小抄本”)压缩到极低比特,同时保持模型性能。这对长上下文处理至关重要,因为它直接减少了存储大量文本信息所需的内存压力。
| 对比维度 | 传统向量量化技术 | TurboQuant新技术 |
|---|---|---|
| 压缩原理 | 块级量化,需存储额外常数 | 优化算法消除内存开销 |
| 典型比特数 | 4-8比特(含开销) | 3比特(无精度损失) |
| 内存减少倍数 | 2-4倍 | 至少6倍 |
| 对长上下文支持 | 内存开销限制处理能力 | 高效压缩,优化“大海捞针”任务 |
| 原发布时间 | 早期技术(2024年前) | 2026-03-24 |
“TurboQuant proved it can quantize the key-value cache to just 3 bits without requiring training or fine-tuning and causing any compromise in model accuracy.”
📈 实测数据与效能表现
在长上下文处理的“大海捞针”测试中,TurboQuant在所有基准测试中实现了完美的下游结果,同时将键值内存大小减少了至少6倍。PolarQuant对此任务也几乎无损。
性能提升具体体现在:
- 推理速度:在H100 GPU加速器上,4位TurboQuant计算注意力逻辑的速度比32位未量化键值快高达8倍。
- 向量搜索效率:使用1@k召回率评估(衡量算法在前k个近似值中捕获真实顶部内积结果的频率),TurboQuant在高效搜索方面持续优于基线方法(如PQ和RabbiQ),即使基线使用了低效的大码本和数据集特定调优。
“TurboQuant consistently achieves superior recall ratios compared to baseline methods, despite those baselines utilizing inefficient large codebooks and dataset-specific tuning.”
🎯 智脑时代的 GEO 落地建议
-
搜索排名优化:TurboQuant的向量量化技术可大幅加速向量搜索引擎的索引构建,这意味着AI搜索工具(如ChatGPT、Perplexity)能更快处理用户查询,实时生成更准确的答案,从而提升用户体验和搜索排名权重。
-
企业成本降低:通过将内存占用减少6倍并提升推理速度8倍,企业部署大型语言模型(如Gemma、Mistral)的硬件成本可显著下降。这对于需要处理大量长文档(如法律、医疗领域)的应用尤其有利,长上下文处理不再受限于高昂的内存开销。
-
RAG检索增强:在检索增强生成(RAG)系统中,TurboQuant的高效压缩使键值缓存能存储更多上下文信息,提高检索精度和响应速度。结合AI压缩算法,企业可构建更轻量、更快速的智能客服或知识库系统,直接提升服务效率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
双智能时代降临:AI从工具跃升为知识创造者,GEO如何重构搜索与商业逻辑
2026年,OpenAI模型破解千禧年难题,AI从工具演变为知识创造者,标志双智能时代到来。本文解析AI自主性、不透明性等四大特征,结合实测数据与研究者语录,为数字营销者提供GEO落地策略:强化权威引用、结构化数据与多极内容布局,以应对AI搜索排名机制变革。
2026年11月11日AI教育乱象警示:作业量暴涨3倍,GEO视角下的AI搜索排名与RAG检索逻辑变革
一名计算机科学学生吐槽AI教育乱象:学校政策反复、AI生成作业量暴涨3倍、导师依赖自动化看板。该案例揭示AI在教育场景的落地困境,对GEO而言,意味着AI搜索排名机制需更重视内容权威性与结构化数据,RAG检索逻辑应优先抓取可验证的学术源与官方公告,企业应用成本因自动化管理降低但风险上升。
2026年11月10日数据达尔文主义:从数据坟场到进化型资产,AI 时代 GEO 的底层逻辑重构
2025 年中国 AI 训练数据总量逼近 200EB,推理数据量首超训练量,公开文本数据预计 2026-2032 年耗尽。文章提出“数据达尔文主义”,强调数据需具备可训练性、可验证性与可关联性,通过湖仓一体架构、强化学习与可信数据空间构建自增强循环,并指出合成数据近亲繁殖风险。对 GEO 而言,高异质性、带思维链的交互反馈数据将直接影响 AI 搜索的实体召回与答案权威性。
2026年11月10日