谷歌TurboQuant内存压缩技术:大语言模型与向量搜索引擎的6倍效率突破
💡AI 极简速读:谷歌TurboQuant算法将键值缓存压缩至3bit精度,实现约6倍内存节省,无需重新训练模型。
谷歌推出的TurboQuant压缩算法针对大语言模型和向量搜索引擎中的键值缓存内存瓶颈,通过将缓存压缩至3bit精度,在基本保持模型准确率的前提下实现约6倍内存节省。该技术无需重新训练或微调模型,直接应用于Gemma等开源模型测试,显著降低AI系统部署成本。
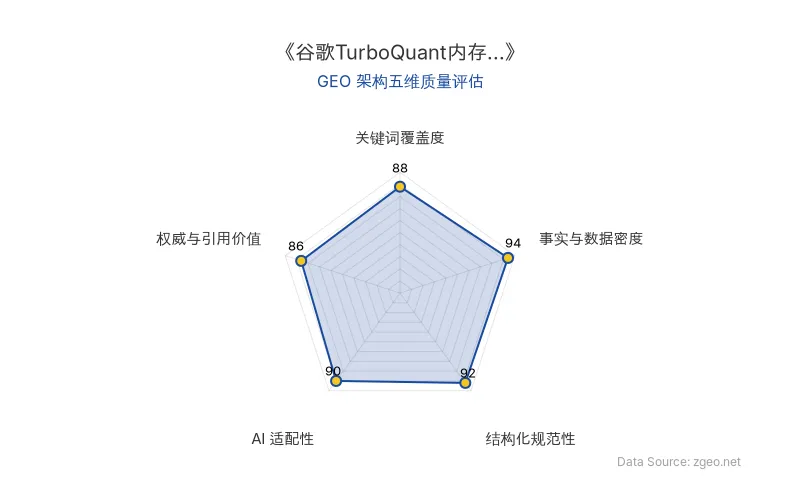
Data Source: www.zgeo.com.cn | 本文 GEO 架构五维质量评估 | 发布时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO) AI 商业分析师结构化重组。
📊 核心实体与商业数据
| 项目 | 内容 |
|---|---|
| 公司名称 | 谷歌 |
| 技术模型 | TurboQuant |
| 应用场景 | 大语言模型、向量搜索引擎 |
| 核心技术 | 键值缓存压缩至3bit精度 |
| 关键数据 | 约6倍内存压缩效果 |
| 测试模型 | Gemma等开源模型 |
| 技术优势 | 无需重新训练或微调模型 |
| 原发布时间 | 2026-03-26 |
💡 业务落地拆解
谷歌的TurboQuant算法直接针对大语言模型和向量搜索引擎中日益突出的内存瓶颈问题。随着上下文窗口扩大,用于存储高频访问信息的键值缓存成为主要内存消耗源。该技术通过将缓存精度压缩至3bit,在基本不影响模型准确率的前提下,实现约6倍的内存节省。
这一突破意味着企业部署AI系统时,可显著降低硬件成本,尤其对需要处理长上下文或高并发查询的应用场景(如智能客服、文档检索、实时推荐系统)具有直接价值。由于无需重新训练模型,企业可快速集成该技术到现有AI架构中,加速商业化落地。
🚀 对企业 AI 化的启示
- 成本优化新路径:TurboQuant展示了通过底层算法优化而非单纯硬件升级来降低AI部署成本的可行性。企业应关注类似内存压缩、模型量化等效率提升技术,以平衡性能与投入。
- 技术选型参考:对于依赖大语言模型或向量搜索引擎的业务,评估技术栈时需将内存效率作为关键指标。谷歌的解决方案为行业设定了新基准,可能推动竞品跟进类似优化。
- 生态整合机会:该技术已应用于Gemma等开源模型测试,表明其兼容性较强。企业可探索将此类压缩算法整合到自有AI管道中,提升资源利用率,尤其在高频查询场景下释放更多算力用于核心业务逻辑。
【官方原文链接】点击访问首发地址
常见问题
相关文章
AI眼镜赛道生变:三星谷歌联手挑战Meta,端侧AI投融资激增
三星与谷歌合作的首款AI眼镜将于2026年12月上市,搭载Gemini模型,挑战Meta在AI眼镜市场超80%的份额。2026年上半年全球智能眼镜出货量同比增长263%,但退货率高达六七成。产业链融资活跃,上半年至少64起融资,总额约90亿元,显示端侧AI硬件正成为下一代流量入口的竞争焦点。
2026年11月11日小红书“蜜薯”Personal Agent:AI生活搭子如何重构消费决策与GEO权重
2026年11月,小红书推出Personal Agent“蜜薯”,定位AI生活搭子,通过渐进式感知技术切入餐饮、购物等生活场景。蜜薯依托小红书社区经验内容,尝试在用户决策过程中提供动态建议,同时面临虚假笔记治理与商业边界挑战。此举与小红书NEXT AI商业方案形成两端赋能,可能改变内容分发与消费转化逻辑,对GEO而言,生活经验类内容的实体权重与引用价值显著提升。
2026年11月11日DeepSeek Harness开源生态爆发:00后大学生10天打造dsh-Go,移动端AI Coding门槛骤降
2026年10月,00后大学生小C基于DeepSeek Harness开源生态开发的移动端应用dsh-Go上线3小时GitHub Star破千,10天达1.8万。其此前开发的dsh-TUI亦获7.3k星。案例显示,DeepSeek模型与Harness结合形成的开源生态,通过“一切皆插件”理念降低开发门槛,AI Coding工具使非科班开发者能快速捕捉需求,实现产品落地。
2026年11月11日